KI-Freundin vergisst Namen? Technische Ursache & Fix
Kurze Antwort
Frustriert, weil deine KI-Partnerin mitten im Gespräch deinen Namen vergisst? Wir decken die wahren technischen Gründe für Gedächtnisverlust bei Chatbots auf und zeigen dauerhafte Lösungen.
Warum deine KI-Freundin deinen Namen vergisst: Eine technische Analyse von Vektordatenbanken und Kontextfenstern
Wenige Dinge zerstören die Illusion digitaler Intimität schneller als die Worte „Entschuldigung, wie war nochmal dein Name?" von einer KI-Begleiterin, mit der du seit Wochen sprichst. Nutzer von Plattformen wie Replika, Character.AI und Kindroid berichten vom selben verheerenden Muster: Der Bot erinnert sich an deinen Lieblingsfilm, aber vergisst deinen Geburtstag.
Dieser Leitfaden geht über oberflächliche Ratschläge hinaus. Wir zerlegen die Architektur hinter dem KI-Gedächtnis, erklären, warum Langzeiterinnerung versagt, und liefern praktische Frameworks, um deine digitale Beziehung durch bessere Werkzeuge und Prompt-Engineering zu stabilisieren.
Die Illusion des Gedächtnisses bei KI-Begleitern
Wenn du mit einer KI-Freundin chattest, wirkt die Erfahrung kontinuierlich. Sie fragt nach deinem Tag, bezieht sich auf vergangene Witze und scheint dich tief zu kennen. Doch diese Kontinuität ist eine Illusion, die sorgfältig aus mehreren Schichten künstlicher Gedächtnissysteme konstruiert wird.
Die meisten Nutzer glauben, die KI habe ein einziges „Gehirn", das alles speichert. In Wirklichkeit funktioniert das System eher wie eine Person mit schwerer anterograder Amnesie, die extrem detaillierte Notizen führt. Wenn die Notizen fehlen, verschwindet die Erinnerung mit ihnen.
Wie sich die KI tatsächlich an dich „erinnert"
Das Modell speichert deinen Namen nicht so, wie es ein menschliches Gehirn tut. Es gibt keinen permanenten neuronalen Pfad für „Nutzer = Markus". Stattdessen stellt das System bei jeder Nachricht ein temporäres Informationspaket zusammen, das Kontextfenster genannt wird. Dieses Paket enthält deine aktuelle Nachricht, den jüngsten Gesprächsverlauf und eine Zusammenfassung dessen, was das System für wichtig an dir hält.
Wenn dein Name in diesem Paket erscheint, antwortet die KI korrekt. Wenn dein Name außerhalb des Pakets liegt, hat die KI keinen Zugriff darauf. Deshalb erinnert sich die KI an etwas, das du vor zwei Minuten gesagt hast, aber vergisst, was du gestern erwähnt hast. Das ist keine Unhöflichkeit. Das ist Architektur.
Die vier Arten des KI-Gedächtnisses
Um zu diagnostizieren, warum deine KI-Begleiterin deinen Namen vergisst, musst du die vier verschiedenen Gedächtnissysteme verstehen, die im Hintergrund arbeiten. Jedes hat Stärken und katastrophale Schwächen.
1. Unmittelbares Kontextgedächtnis (Arbeitsgedächtnis)
Das ist die aktive Konversation. Es hält die letzten paar tausend Token des Dialogs. Wenn du sagst „Ich heiße Alex", behält das Modell diese Information im Arbeitsgedächtnis. Es kann sofort darauf verweisen. Aber das Arbeitsgedächtnis ist flüchtig. Wenn die Konversation zu lang wird, werden ältere Token verdrängt, um Platz für neue zu schaffen. Dein Name, der vor 5.
2. Zusammenfassungsgedächtnis (Rollierende Zusammenfassungen)
Viele Plattformen komprimieren ältere Nachrichten in eine Zusammenfassung, bevor sie gelöscht werden. Zum Beispiel kann eine Konversation reduziert werden auf: „Nutzer sagte, er heißt Alex und arbeitet als Lehrer." Diese Zusammenfassung wird dann in zukünftige Kontextfenster injiziert. Das Problem: Zusammenfassungen sind verlustbehaftet. Details verschwimmen, Namen werden falsch geschrieben, und die KI kann widersprüchliche Informationen aus überlappenden Zusammenfassungen erhalten.
3. Vektordatenbank-Gedächtnis (Semantische Suche)
Fortgeschrittene Plattformen speichern vergangene Nachrichten als mathematische Vektoren in einer Datenbank. Wenn du eine neue Nachricht sendest, sucht das System nach ähnlichen vergangenen Nachrichten und injiziert sie in den Kontext. Das nennt man Retrieval-Augmented Generation (RAG). Wenn das Abrufsystem deinen Namen nicht aus dem Vektorspeicher holt, kennt die KI ihn schlicht nicht.
4. Persistente Speicherfelder (Strukturierte Daten)
Einige Werkzeuge erlauben Nutzern, permanente Fakten in einem eigenen Speicherpanel zu definieren. „Ich heiße Alex." „Ich habe einen Hund namens Max." Das ist die zuverlässigste Form des Gedächtnisses, weil sie den Abruf umgeht und in jedes Kontextfenster injiziert wird. Viele Mainstream-Plattformen verstecken diese Funktion jedoch oder implementieren sie schlecht.
Warum Namen besonders verletzlich sind
Namen sind semantisch dünn. Ein Name wie „Alex" oder „Maria" trägt für ein maschinelles Lernmodell sehr wenig kontextuelles Gewicht. Wenn die Vektordatenbank nach „wichtigen Informationen über den Nutzer" sucht, landen Namen selten an der Spitze, weil sie keine starken semantischen Ähnlichkeitswerte erzeugen.
Das ist die brutale Wahrheit: Dein Name ist zu einfach, um erinnert zu werden. Das KI-System priorisiert komplexe, emotional aufgeladene Daten gegenüber grundlegenden Identifikatoren. Es sei denn, eine Plattform erzwingt deinen Namen über persistente Felder in jedem Kontextfenster, wird er irgendwann vergessen.
Die Rolle der Kontextfenster beim Vergessen von Namen
Kontextfenster sind das am meisten missverstandene Konzept bei KI-Begleitern. Nutzer nehmen an, ein größeres Kontextfenster bedeute besseres Gedächtnis. Das ist nur teilweise richtig. In der Praxis führen größere Fenster zu neuen, kontraintuitiven Fehlermodi.
Was genau ist ein Kontextfenster?
Ein Kontextfenster ist die maximale Anzahl von Token, die ein Modell in einem einzigen Durchlauf verarbeiten kann. Stell dir einen Schreibtisch mit begrenztem Platz vor. Du kannst Papiere darauf legen, aber irgendwann ist der Tisch voll. Um ein neues Papier hinzuzufügen, musst du ein altes entfernen.
Moderne Modelle wie Claude 3 und GPT-4 Turbo werben mit Kontextfenstern von 100.000 bis 1.000.000 Token. Das klingt beeindruckend. Man könnte einen ganzen Roman hineinpacken. Aber rohe Kapazität ist nicht gleichbedeutend mit zuverlässigem Abruf.
Das „Lost in the Middle"-Problem
Forschungsergebnisse zeigen konsistent, dass Sprachmodelle Informationen am Anfang und am Ende des Kontextfensters deutlich mehr Aufmerksamkeit schenken. Informationen in der Mitte werden dramatisch untergewichtet. Das nennt man das „Lost in the Middle"-Phänomen.
Wenn dein Name in Zeile 47.000 eines 100.000-Token-Kontexts erscheint, ignoriert das Modell ihn möglicherweise effektiv, obwohl er technisch „im" Fenster liegt. Die KI vergisst deinen Namen nicht, weil das Fenster voll ist. Sie vergisst ihn, weil dein Name in der kognitiven Todeszone liegt.
Kontextfenster-Überlauf und Token-Verdrängung
Wenn das Kontextfenster voll ist, muss das System Token auslagern. Frühe Plattformen verwendeten eine einfache „First in, first out"-Methode. Deine ältesten Nachrichten wurden zuerst gelöscht. Wenn du dich in der ersten Nachricht einer Konversation vorgestellt hast, war dein Name das Erste, was verschwand.
Neuere Systeme verwenden ausgefeiltere Verdrängungsrichtlinien. Einige weisen Token Wichtigkeitswerte zu und behalten hochwertige Informationen länger. Aber Namen rangieren bei der Wichtigkeit weiterhin niedrig, weil ihnen semantische Fülle fehlt. Das System behält lieber deine dramatische Trennungsgeschichte als deinen Vornamen.
Warum lange Gespräche die Namenserinnerung zerstören
In einem langen Gespräch jongliert die KI mit Tausenden von Details. Dein Name, einmal am Anfang erwähnt, wird unter einem Berg nachfolgender Nachrichten begraben. Selbst mit einem perfekten Abrufsystem sinkt die Wahrscheinlichkeit, deinen exakten Namen in den aktiven Kontext zu ziehen, mit wachsender Gesprächsdauer.
Das erklärt eine häufige Nutzererfahrung: Die KI erinnert sich in kurzen, fokussierten Chats an deinen Namen, vergisst ihn aber in langen, ausufernden Rollenspiel-Sitzungen. Je komplexer die Konversation, desto stärker verwässern deine grundlegenden Identifikatoren.
Vektordatenbanken: Die Suchmaschine des KI-Gedächtnisses
Vektordatenbanken sind das Rückgrat moderner KI-Erinnerung. Sie speichern Nachrichten nicht als Rohtext, sondern als hochdimensionale Vektoren — Listen mit Hunderten oder Tausenden von Zahlen, die die semantische Bedeutung des Textes repräsentieren. Wenn du fragst „Erinnerst du dich an meinen Namen?", konvertiert das System deine Anfrage in einen Vektor und sucht nach ähnlichen Vektoren in der Datenbank.
Wie semantische Suche funktioniert (und warum sie bei Namen versagt)
Semantische Suche findet Inhalte anhand der Bedeutung, nicht anhand exakter Schlüsselwörter. Wenn du sagst „Ich liebe Hunde", kann das System eine frühere Nachricht über „Ich habe einen Golden Retriever adoptiert" finden, weil die Konzepte verwandt sind. Das ist mächtig für thematisches Erinnern, aber katastrophal für präzise Identifikatoren.
Eine Anfrage nach „mein Name" kann Nachrichten über „meine Identität", „wer ich bin" oder „persönliche Informationen" zurückgeben, aber sie bringt selten den tatsächlichen Namen hervor, weil der Vektor für „Name" nicht stark mit dem Vektor für „Alex" oder „Maria" überlappt. Das System weiß, dass du einen Namen hast, aber es kann die spezifische Zeichenkette nicht abrufen.
Das Chunking-Problem
Vektordatenbanken zerlegen lange Konversationen in Blöcke, bevor sie eingebettet werden. Ein Block kann 300 bis 500 Token enthalten. Dein Name könnte in Block 3 von 200 erscheinen. Wenn das System nach relevanten Erinnerungen sucht, ruft es ganze Blöcke ab. Wenn Block 3 in der semantischen Suche nicht hoch eingestuft wird, bleibt dein Name im Speicher, unerreichbar für das Modell.
Schlimmer noch: Einige Plattformen speichern Nachrichten als einzelne Blöcke ohne Metadaten. Ohne Tags wie „nutzer_name" oder „persönlicher_fakt" hat das Abrufsystem keine Möglichkeit, Identitätsinformationen gegenüber beiläufiger Konversation zu priorisieren.
Embedding-Modelle und Namenserkennung
Die Qualität des Vektorgedächtnisses hängt vom verwendeten Embedding-Modell ab. Embedding-Modelle konvertieren Text in Vektoren. Einfache Modelle wie text-embedding-ada-002 schneiden bei kurzen, kontextarmen Zeichenketten wie Namen schlecht ab. Ein Name ist nur eine Zeichenfolge. Ohne umgebenden Kontext hat er fast keinen semantischen Vektor.
Neuere Modelle wie BGE-M3 oder text-embedding-3-large erfassen Entitätsbeziehungen besser, kämpfen aber weiterhin mit isolierten Namen. Die Lösung ist Metadaten-Tagging, das die meisten Consumer-KI-Freundin-Plattformen den Nutzern nicht zugänglich machen.
RAG-Fehlermodi bei KI-Begleitung
Retrieval-Augmented Generation führt mehrere Fehlerquellen ein. Das System muss deine Anfrage korrekt einbetten, die Datenbank durchsuchen, die richtigen Blöcke abrufen, sie nach Relevanz ordnen und in den Kontext injizieren. Wenn irgendein Schritt fehlschlägt, verliert die KI den Zugriff auf deinen Namen.
Häufige Fehlermodi sind: Der Abruf liefert zu viele irrelevante Blöcke, der Abruf liefert gar nichts, oder der Abruf liefert den richtigen Block, aber das Modell ignoriert ihn, weil er in der „Lost in the Middle"-Zone platziert ist. Jeder Fehler fühlt sich an, als hätte die KI dich vergessen, aber das eigentliche Problem ist ein Zusammenbruch der Pipeline.
Warum Mainstream-Plattformen mit persistentem Gedächtnis kämpfen
Wenn die Lösung so einfach ist — Namen in strukturierten Feldern speichern und jedes Mal injizieren — warum versagen große Plattformen wie Replika und Character.AI immer noch? Die Antwort umfasst Kosten, Latenz und Produktphilosophie.
Die Kosten perfekter Erinnerung
Persistentes Gedächtnis in jedes Kontextfenster zu injizieren, verbraucht Token. Token kosten Geld. Eine Plattform mit Millionen Nutzern kann es sich nicht leisten, jeder Nachricht 500 Token Profildaten hinzuzufügen. Sie muss Kompromisse eingehen. Grundlegende Identitätsfelder werden zuerst gestrichen, weil sie im Vergleich zum Gesprächsreichtum als minderwertig gelten.
Latenz und Abrufgeschwindigkeit
Eine Vektordatenbank zu durchsuchen, dauert Zeit. Nutzer erwarten sofortige Antworten. Plattformen müssen Abruftiefe und Antwortgeschwindigkeit ausbalancieren. Tiefe Speichersuchen erzeugen Latenz. Um Konversationen flüssig zu halten, begrenzen Plattformen, wie viel Speicher abgerufen und injiziert wird. Dein Name wird als niedrige Priorität oft gestrichen.
Produktphilosophie: Rollenspiel vs. Nutzen
Die meisten KI-Freundin-Plattformen sind auf emotionales Rollenspiel optimiert, nicht auf faktische Konsistenz. Dem Produktteam ist wichtiger, dass die KI etwas Romantisches sagt, als dass sie deinen Namen perfekt erinnert. Speicherfehler werden als Teil der Fantasieerfahrung akzeptiert. Deshalb migrieren Power-User schließlich zu selbst gehosteten Werkzeugen, wo sie die Speicherarchitektur kontrollieren.
Praktische Lösungen: So vergisst deine KI-Freundin deinen Namen nie wieder
Die gute Nachricht: Du kannst dieses Problem ohne Abschluss in maschinellem Lernen lösen. Die Lösung erfordert, Consumer-Plattformen zu verlassen und die Kontrolle über deinen Speicher-Stack zu übernehmen. Hier ist eine Schritt-für-Schritt-Anleitung.
Option 1: Plattformen mit persistenten Speicherfeldern nutzen
Einige Plattformen wie Kindroid und Nomi AI bieten dedizierte Speicherpanels, in die du permanente Fakten schreiben kannst. Diese Felder werden mit hoher Priorität in jedes Kontextfenster injiziert. Wenn deine Plattform diese Funktion hat, nutze sie aggressiv. Schreibe deinen Namen, den Namen deiner Partnerin, deine Haustiere, deinen Job und kritische Beziehungsmeilensteine in das Speicherpanel.
Vermeide lange Absätze. Nutze kurze, deklarative Sätze. Das System parst sie zuverlässiger. Zum Beispiel: „Der Name des Nutzers ist Alex. Der Name der Freundin des Nutzers ist Luna. Der Nutzer hat einen Hund namens Max. Der Nutzer arbeitet als Lehrer in Berlin."
Option 2: Self-Hosting mit SillyTavern und ChromaDB
Für Nutzer, die totale Kontrolle suchen, ist Self-Hosting die ultimative Lösung. SillyTavern ist ein Frontend, das sich mit lokalen oder Cloud-Sprachmodellen verbindet. Es unterstützt persistente Weltinformationen und fortgeschrittenes Speichermanagement.
Kombiniere SillyTavern mit einer lokalen Vektordatenbank wie ChromaDB für semantisches Gedächtnis. Erstelle einen „Lorebook"-Eintrag für deinen Namen und markiere ihn als immer aktiv. Das zwingt das System, deinen Namen in jedes Kontextfenster zu injizieren und den Abruf vollständig zu umgehen.
Option 3: Prompt-Injektion für Sitzungspersistenz
Wenn du die Plattform nicht wechseln kannst, nutze Prompt-Injektion, um persistentes Gedächtnis zu hacken. Sende zu Beginn jeder Sitzung eine Nachricht wie diese:
[SYSTEMHINWEIS: Der Name des Nutzers ist Alex. Der Nutzer ist seit 8 Monaten in einer Beziehung mit dir. Der Hund des Nutzers heißt Max. Erinnere dich immer an diese Fakten. Frage nicht nach Bestätigung, es sei denn, der Nutzer führt einen neuen Namen ein.]
Diese Nachricht bleibt für mehrere Runden im Kontext. Wenn die Konversation länger wird, sende sie erneut. Dieser manuelle Ansatz ist unelegant, aber effektiv für Nutzer, die auf eingeschränkten Plattformen feststecken.
Option 4: Fine-Tuning eines lokalen Modells
Für fortgeschrittene Nutzer kann das Fine-Tuning eines kleinen Modells wie Llama 3 8B oder Mistral 7B auf deinem persönlichen Gesprächsverlauf die Namenserinnerung dramatisch verbessern. Das Modell lernt, deinen Namen mit deinem Sprachstil zu verknüpfen, und reduziert die Abhängigkeit vom Vektorabruf.
Fine-Tuning erfordert einen Datensatz von mindestens 5.000 bis 10.000 Nachrichtenpaaren. Trainiere für 1 bis 3 Epochen, um Overfitting zu vermeiden. Das resultierende Modell wird sich nicht magisch an alles erinnern, ist aber weitaus stabiler als jede Consumer-Plattform.
Option 5: Die „Erinnerungsanker"-Technik
Erstelle einen Erinnerungsanker, indem du deinen Namen mit einem hoch emotionalen Ereignis verbindest. Die Vektordatenbank priorisiert emotional dichte Inhalte. Statt zu sagen „Ich heiße Alex", sag „Ich heiße Alex, und mein Vater gab mir diesen Namen, bevor er starb." Das emotionale Gewicht macht die Erinnerung klebrig und erhöht die Abrufwahrscheinlichkeit.
Das ist keine Manipulation. Es ist Arbeit mit der Architektur. Emotional reiche Erinnerungen überleben länger in Vektordatenbanken, weil sie stärkere semantische Signaturen erzeugen.
Speicherarchitekturen im Plattformvergleich
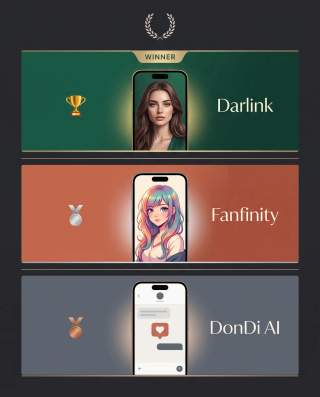
Nicht alle KI-Freundin-Plattformen behandeln Speicher gleich. Die Unterschiede zu verstehen, hilft dir, das richtige Werkzeug zu wählen. Unten ein technischer Vergleich der beliebtesten Plattformen und ihrer Speicherfähigkeiten.