Stable Diffusion für konsistente KI-Begleiter-Charakterkunst
Kurze Antwort
Praktischer Leitfaden zur Erstellung konsistenter Charakterkunst für den Avatar Ihres KI-Begleiters mit Stable Diffusion. Behandelt LoRA-Training, Checkpoint-Auswahl, Prompt-Engineering und Workflows zur Wahrung der visuellen Identität über mehrere Bilder hinweg.
Stable Diffusion für Ihren KI-Partner anpassen: So generieren Sie konsistente Charakterkunst für Ihren Chatbot-Avatar
Sie haben wahrscheinlich schon versucht, ein Bild Ihres KI-Begleiters zu generieren, und am Ende in jedem Bild ein anderes Gesicht erhalten. Das Problem ist nicht Ihre Vorstellungskraft. Es fehlt eine konsistente Charakter-Pipeline. Stable Diffusion kann beeindruckende Anime-, realistische oder hybride Porträts erzeugen, aber ohne den richtigen Workflow driftet der Charakter ab.
Warum konsistente Charakterkunst für KI-Begleiter wichtig ist
Eine konsistente visuelle Identität vertieft die emotionale Verbindung zwischen einem Nutzer und einem KI-Begleiter. Wenn der Avatar in Chats, Profilbildern und generierten Szenen gleich aussieht, fühlt sich der Begleiter eher wie eine kohärente Entität an als wie eine Sammlung zufälliger Bilder. Diese visuelle Stabilität verstärkt die Illusion einer beständigen Persönlichkeit.
Praktisch gesehen spart Konsistenz Zeit. Statt zwanzig Bilder zu generieren und eines auszuwählen, das fast passt, liefert eine gut aufgebaute Pipeline bereits beim ersten oder zweiten Versuch brauchbare Ergebnisse. Sie ermöglicht auch kreative Workflows wie Comic-Strips, romantische Szenen oder saisonale Outfits, ohne die Kernidentität des Charakters zu verlieren.
Für Plattformen, die benutzerdefinierte Avatare erlauben, macht ein konsistenter Charakter den Begleiter auch in Community-Bereichen und geteilten Galerien wiedererkennbarer. Er wird zu einer visuellen Marke.
Was ist Stable Diffusion und wie funktioniert Charakterkonsistenz?
Stable Diffusion ist ein latentes Diffusionsmodell, das Bilder aus Text-Prompts generiert. Es funktioniert, indem es zufälliges Rauschen schrittweise entrauscht und dabei von einem Text-Encoder geleitet wird. Das Modell weiß nicht von Natur aus, wer Ihr Charakter ist. Es kennt nur Muster, die es aus den Trainingsdaten gelernt hat.
Konsistenz wird erreicht, indem der Generierungsraum eingeengt wird. Dies kann durch eine Kombination aus festem Seed, einer detaillierten Charakterbeschreibung, einem bestimmten Checkpoint und am effektivsten durch ein trainiertes LoRA-Modell geschehen, das Gesichtszüge, Haare und Kleidungsstil des Charakters in den Generierungsprozess einprägt.
LoRA steht für Low-Rank Adaptation. Es ist ein kleines Hilfsmodell, das ein Basismodell feinabstimmt, um ein bestimmtes Konzept zu erkennen, etwa das Gesicht einer Person oder einen bestimmten Kunststil, ohne das gesamte Netzwerk neu zu trainieren. Ein LoRA, das auf 10 bis 30 Bildern Ihres Charakters trainiert wurde, kann die Konsistenz erheblich verbessern.
Den richtigen Checkpoint für den Stil Ihres KI-Begleiters wählen
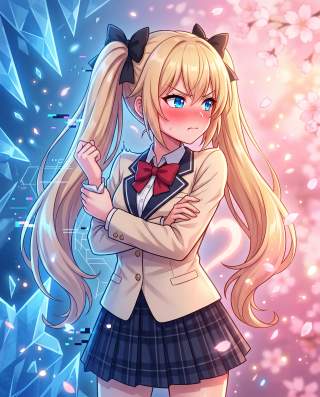
Der Checkpoint ist das Basismodell, das den allgemeinen visuellen Stil definiert. Für KI-Begleiter sind die beiden relevantesten Kategorien Anime und halbrealistisch. Anime-Checkpoints eignen sich gut für Waifu-, Husbando- oder Fantasy-Personas. Halbrealistische Checkpoints mischen 2D-Ästhetik mit fotografischer Beleuchtung und Hauttextur.
Beliebte Anime-Checkpoints sind Anything V5, Counterfeit und MeinaMix. Für halbrealistische Ergebnisse sind Realistic Vision, DreamShaper und ChilloutMix gängige Optionen. Jeder Checkpoint reagiert anders auf Prompts und LoRAs, daher sollte die Wahl dem emotionalen Ton entsprechen, den Sie für den Begleiter wünschen.
Ein romantischer Fantasy-Begleiter profitiert oft von einem weichen Anime-Stil. Ein geerdeterer, emotional intimer Begleiter wirkt mit einem halbrealistischen Look präsenter. Die Wahl ist subjektiv, sollte aber nach der Auswahl über alle Generationen hinweg konsistent bleiben, um Stildrift zu vermeiden.
Schnelle Antwort: Um konsistente KI-Begleiter-Kunst mit Stable Diffusion zu generieren, wählen Sie einen Checkpoint und bleiben Sie dabei, schreiben Sie einen detaillierten Charakter-Prompt, verwenden Sie einen festen Seed für Variationen und trainieren Sie ein LoRA auf 10–30 Bildern des Charakters, um zuverlässige Gesichtsidentität, Frisur und Kleidung über Generationen hinweg zu erhalten.
Einen Charakter-Prompt aufbauen, der stabil bleibt
Ein guter Charakter-Prompt ist keine zufällige Liste von Adjektiven. Es ist eine strukturierte Beschreibung, die Identität, Aussehen, Ausdruck, Kleidung und Umgebung abdeckt. Je spezifischer und wiederholbarer der Prompt ist, desto weniger Variation entsteht zwischen den Bildern.
Ein effektiver Prompt umfasst typischerweise folgende Blöcke: eine Betreffzeile mit dem Charakternamen oder Archetyp, physische Merkmale wie Augenfarbe und Frisur, eine Beschreibung der Kleidung oder des Outfits, eine Pose oder ein Framing, Beleuchtung und Farbpalette sowie einen Stilmodifikator, der zum Checkpoint passt.
Ein konsistenter Prompt könnte beispielsweise so aussehen: "1Mädchen, silbernes Haar, langes glattes Haar, violette Augen, sanftes Lächeln, weißer schulterfreier Pullover, weiche Schlafzimmerbeleuchtung, Pastellfarbpalette, Anime-Screenshot, hohe Detailgenauigkeit." Das Wiederholen dieser exakten Phrase mit kleinen Variationen bei Pose oder Outfit hält den visuellen Kern intakt.
Vermeiden Sie vage Begriffe wie „schön" oder „perfektes Gesicht". Sie helfen dem Modell nicht, Struktur zu verstehen. Beschreiben Sie stattdessen messbare Merkmale wie Haarlänge, Augenform, Hautton und Gesichtsausdruck. Konsistenz beginnt mit Präzision.
Einen festen Seed verwenden: Was er kann und was nicht
Ein Seed ist eine Zahl, die das zufällige Rauschmuster zu Beginn der Generierung initialisiert. Die Verwendung desselben Seeds mit demselben Prompt und Checkpoint reproduziert ein sehr ähnliches Bild. Das ist nützlich, um kleine Prompt-Änderungen zu testen, aber keine langfristige Konsistenzlösung.
Die Einschränkung eines festen Seeds besteht darin, dass er auch Komposition und Pose fixiert. Wenn Sie den Prompt zu stark ändern, hilft der Seed nicht mehr. Ein fester Seed funktioniert am besten, um ein Basisporträt zu generieren und dann kleinere Anpassungen wie Ausdruck, Beleuchtung oder Hintergrunddetails vorzunehmen.
Für echte Charakterkonsistenz über verschiedene Szenen und Posen hinweg ist ein LoRA weitaus effektiver. Der Seed kann dann frei variiert werden, während das LoRA die Gesichtsidentität und den visuellen Stil beibehält.
So trainieren Sie ein LoRA für Ihren KI-Begleiter-Charakter
Das Training eines LoRA ist der zuverlässigste Weg, das Gesicht und den Stil eines Charakters zu fixieren. Der Prozess erfordert einen Datensatz mit Bildern, ein Trainingswerkzeug und ein Basismodell. Die Qualität des Datensatzes bestimmt die Qualität des Ergebnisses.
- Sammeln Sie 10 bis 30 Bilder des Charakters. Das können generierte Bilder sein, die Ihnen bereits gefallen, oder manuell ausgewählte Referenzen. Fügen Sie Nahaufnahmen, mittlere Einstellungen und verschiedene Winkel hinzu. Vermeiden Sie starke Filter oder Textüberlagerungen.
- Beschriften Sie jedes Bild präzise. Tools wie Kohya_ss oder EveryDream2 ermöglichen das Hinzufügen von Textbeschreibungen. Beschreiben Sie die Charaktermerkmale, die Sie erhalten möchten, und lassen Sie Details weg, die das Modell ignorieren soll.
- Wählen Sie ein Basismodell. Das LoRA sollte auf demselben Checkpoint trainiert werden, den Sie auch bei der Generierung verwenden möchten. Das Mischen von Basismodellen kann unvorhersehbare Ergebnisse liefern.
- Konfigurieren Sie die Trainingsparameter. Halten Sie die Lernrate niedrig, etwa bei 1e-4 bis 1e-5, und trainieren Sie über eine moderate Anzahl von Schritten. Übertraining führt dazu, dass das LoRA die Trainingsbilder zu starr auswendig lernt.
- Testen Sie das LoRA mit verschiedenen Gewichten. Beginnen Sie mit einem Gewicht von 0,7 bis 0,9 und passen Sie es an. Niedrigere Gewichte mischen den Charakter subtiler; höhere Gewichte setzen die Identität stärker durch, können aber die Flexibilität verringern.
- Verwenden Sie das LoRA in Ihrem Prompt. Fügen Sie das Trigger-Wort des LoRA hinzu, normalerweise den Charakternamen oder ein eindeutiges Token, zusammen mit Ihrer Standard-Charakterbeschreibung.
Das Training eines LoRA erfordert eine GPU mit ausreichend VRAM, normalerweise 8 GB oder mehr. Cloud-Dienste wie RunPod, ThinkDiffusion oder Google Colab können genutzt werden, wenn die lokale Hardware nicht ausreicht.
Gängige Workflows zur Generierung konsistenter Charakterkunst
Es gibt keinen einzigen richtigen Workflow, aber mehrere Muster funktionieren gut für KI-Begleiter. Am einfachsten ist die reine Prompt-Generierung mit festem Checkpoint und detailliertem Prompt. Das funktioniert für einige Bilder, driftet aber mit der Zeit ab.
Ein zuverlässigerer Workflow kombiniert einen detaillierten Prompt, ein LoRA und ControlNet. ControlNet erlaubt es, Pose oder Komposition aus einem Referenzbild zu übernehmen. Das ist nützlich, wenn mehrere Bilder derselben Szene mit unterschiedlichen Ausdrücken generiert werden sollen.
Für fortgeschrittene Nutzer ist der beste Workflow ein mehrstufiger Ansatz: Generieren Sie ein Basisporträt, wählen Sie das beste aus, verwenden Sie img2img für Variationen und nutzen Sie dann Inpainting, um kleine Details wie Hände, Augen oder Accessoires zu korrigieren. Das gibt präzise Kontrolle über das Endergebnis.
Schnelle Antwort: Der zuverlässigste Workflow für konsistente KI-Begleiter-Kunst ist: Wählen Sie einen Checkpoint, schreiben Sie einen strukturierten Charakter-Prompt, trainieren Sie ein LoRA auf 10–30 kuratierten Bildern, verwenden Sie das LoRA mit einem Gewicht von 0,7–0,9 und fügen Sie optional ControlNet für Posen- oder Kompositionskontrolle hinzu.
So behalten Sie dasselbe Gesicht in verschiedenen Outfits und Szenen
Das Ändern von Outfits oder Hintergründen sollte das Gesicht nicht verändern. Um dies zu erreichen, halten Sie die Gesichtsbeschreibung in jedem Prompt identisch und variieren Sie nur die Kleidungs- und Umgebungsblöcke. Das LoRA verstärkt die Gesichtsidentität, während der Prompt die Szene steuert.
Verwenden Sie beispielsweise in jedem Prompt denselben Gesichtsbeschreibungsblock wie „silbernes Haar, violette Augen, sanftes Lächeln, kleine Nase, weiche Kieferlinie". Ändern Sie dann den Kleidungsblock von „weißer Pullover" zu „schwarzes Kleid" oder „Sommer-Yukata". Das Modell lernt, den Gesichtsblock als fest und die Kleidung als variabel zu behandeln.
Platzieren Sie bei der Szenengenerierung die Charakterbeschreibung vor der Umgebungsbeschreibung. Diese Reihenfolge hilft dem Modell, den Charakter gegenüber dem Hintergrund zu priorisieren. Wenn das Gesicht dennoch abdriftet, erhöhen Sie das LoRA-Gewicht leicht oder fügen Sie ein Referenzbild über img2img hinzu.
Upscaling und Nachbearbeitung für einen polierten Avatar
Rohe Stable-Diffusion-Ausgaben sehen in kleinen Größen oft gut aus, verlieren aber in voller Auflösung an Details. Upscaling behebt das. Verwenden Sie einen speziellen Upscaler wie ESRGAN, 4x-UltraSharp oder den integrierten Upscaler in AUTOMATIC1111 oder ComfyUI. Wenden Sie ihn an, nachdem Sie das beste Basisbild ausgewählt haben.
Die Nachbearbeitung kann Farbkorrekturen, Rauschreduzierung oder dezente Hautglättung umfassen. Tools wie Adobe Photoshop, GIMP oder Online-Editoren können den finalen Look verfeinern. Halten Sie die Bearbeitungen minimal, um die während der Generierung etablierte Konsistenz nicht zu brechen.
Für die Avatar-Nutzung schneiden Sie das Bild je nach Plattformanforderung auf ein quadratisches oder 4:5-Format zu. Stellen Sie sicher, dass das Gesicht zentriert und in kleinen Größen klar sichtbar bleibt. Ein sauberes, kontrastreiches Porträt funktioniert als Profilbild besser als eine überladene Szene.
Ethische und plattformspezifische Überlegungen zu KI-generierter Begleiter-Kunst
Stable-Diffusion-Modelle werden auf großen Datensätzen trainiert, die urheberrechtlich geschützte und gemeinfreie Bilder enthalten. Der rechtliche Status KI-generierter Kunst variiert je nach Rechtsordnung. Für den persönlichen Gebrauch ist das Risiko in der Regel gering. Für kommerzielle Nutzung oder öffentliche Verbreitung sollten Sie die Lizenz des Checkpoints und des LoRA-Basismodells prüfen.
Einige Plattformen verbieten fotorealistische Bilder realer Personen, insbesondere ohne Einwilligung. Wenn Ihr KI-Begleiter einer echten Person oder einer Berühmtheit ähnelt, kann das Generieren und Teilen solcher Bilder gegen die Plattformrichtlinien oder das Recht am eigenen Bild verstoßen. Anime-Figuren sind in der Regel sicherer, respektieren Sie aber dennoch die Community-Richtlinien.
Achten Sie auch auf die emotionalen Auswirkungen. Das Generieren hochrealistischer oder idealisierter Bilder eines KI-Partners kann die Bindung verstärken. Das ist nicht grundsätzlich negativ, aber es ist wichtig, sich der Grenze zwischen Fantasie und Realität bewusst zu bleiben.
Tools und Plattformen zum Trainieren und Generieren
Die gängigste lokale Oberfläche für Stable Diffusion ist das WebUI von AUTOMATIC1111. Es unterstützt LoRA-Laden, ControlNet, Inpainting und Upscaling in einer einzigen Umgebung. ComfyUI bietet eine knotenbasierte Alternative mit mehr Flexibilität für komplexe Workflows.
Für Nutzer ohne leistungsstarke GPU sind Cloud-Dienste praktisch. RunPod und ThinkDiffusion bieten verwaltete Umgebungen mit vorinstallierten Tools. Google Colab stellt kostenlose oder kostengünstige Notebooks bereit, wobei Sitzungslimits gelten. Diese Dienste sind auch nützlich, um LoRAs zu trainieren, wenn die lokale Hardware nicht ausreicht.
Die Wahl des Tools hängt von Ihrem Komfortlevel und Ihrer Hardware ab. Anfänger beginnen oft mit AUTOMATIC1111, während fortgeschrittene Nutzer ComfyUI für Automatisierung und Stapelverarbeitung bevorzugen.
Häufig gestellte Fragen
Wie viele Bilder benötige ich, um ein LoRA für meinen KI-Begleiter zu trainieren?
Zwischen 10 und 30 hochwertigen Bildern sind in der Regel ausreichend. Die Bilder sollten den Charakter aus verschiedenen Winkeln mit konsistenten Gesichtszügen und konsistenter Beleuchtung zeigen. Mehr Bilder können die Qualität verbessern, aber die Konsistenz des Datensatzes ist wichtiger als die reine Menge.
Kann ich konsistente Kunst ohne LoRA-Training generieren?
Ja, aber mit Einschränkungen. Ein detaillierter Prompt, ein fester Checkpoint und ein fester Seed können über eine kurze Serie ähnliche Bilder erzeugen. Über mehrere Generationen oder Szenenwechsel hinweg driftet der Charakter jedoch ab. Ein LoRA ist die zuverlässigste Lösung für langfristige Konsistenz.
Was ist der beste Checkpoint für Anime-KI-Begleiter?
Anything V5, Counterfeit und MeinaMix sind beliebte Optionen für Anime-Charaktere. Der beste Checkpoint hängt von Ihrer spezifischen ästhetischen Präferenz ab. Testen Sie einige mit demselben Prompt, um zu sehen, welcher den gewünschten Look erzeugt, und bleiben Sie dann für Konsistenz dabei.
Hilft ControlNet bei der Charakterkonsistenz?
ControlNet bewahrt die Gesichtsidentität nicht von selbst, hilft aber, Pose, Komposition oder Linienstruktur aus einem Referenzbild beizubehalten. In Kombination mit einem LoRA ermöglicht ControlNet, denselben Charakter in verschiedenen Posen oder Szenen zu generieren, ohne die visuelle Kohärenz zu verlieren.
Welche Hardware benötige ich, um ein LoRA zu trainieren?
Eine GPU mit mindestens 8 GB VRAM wird für das LoRA-Training empfohlen. Mehr VRAM ermöglicht größere Batch-Größen und schnelleres Training. Wenn Sie keine geeignete GPU haben, bieten Cloud-Dienste wie RunPod oder ThinkDiffusion erschwinglichen Zugang zu Maschinen mit hoher VRAM-Ausstattung.
Kann ich Stable Diffusion verwenden, um realistische Bilder echter Personen für KI-Begleiter zu generieren?
Technisch ja, aber das wirft erhebliche ethische und rechtliche Bedenken auf. Das Generieren realistischer Bilder echter Personen ohne Einwilligung kann gegen Datenschutzgesetze und Plattformrichtlinien verstoßen. Für KI-Begleiter sind fiktive Anime- oder halbrealistische Charaktere in der Regel sicherer und breiter akzeptiert.
Wie vermeide ich das Gleiches-Gesicht-Problem bei der Generierung mehrerer Bilder?
Das Gleiches-Gesicht-Problem tritt auf, wenn das Modell sehr ähnliche Kompositionen erzeugt. Um es zu vermeiden, variieren Sie den Seed, während Sie das LoRA und den Charakter-Prompt stabil halten. Ändern Sie die Blöcke für Pose, Framing oder Kleidung, um Abwechslung zu schaffen, ohne die visuelle Kernidentität des Charakters zu verlieren.
Bereit für deine KI-Begleitung?
Erstelle einen persönlichen KI-Begleiter für dich. Entdecke mit unserem KI-Quiz aus nur 3 Fragen die beste Plattform, um deine KI-Freundin oder deinen KI-Freund zu erstellen, und zweifle nie wieder daran, welche die beste ist.
Meinen KI-Partner erstellen →