L'Illusion de la Mémoire Token : Prompting pour une Cohérence Narrative à Long Terme en IA
Réponse rapide
Les compagnes IA oublient des choses. C'est la plainte la plus courante de la communauté. Mais le problème n'est pas la mémoire — c'est la façon dont les prompts gèrent le contexte.
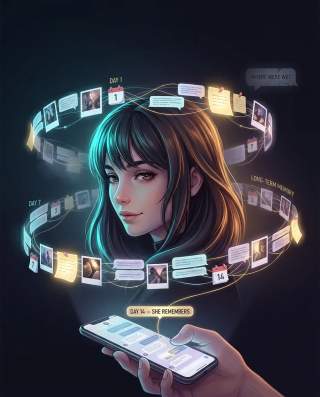
Ce que les utilisateurs perçoivent comme de la mémoire est en réalité de la gestion de contexte. Le modèle ne stocke pas de faits vous concernant dans une base de données persistante, sauf si la plateforme en fournit une explicitement. Au lieu de cela, il lit ce qui se trouve dans la fenêtre de contexte au moment de la génération. Lorsque la fenêtre de contexte se remplit, les anciennes informations sont évincées. L'IA n'oublie pas. Elle perd simplement l'accès au texte qui contenait la mémoire.
C'est l'Illusion de la Mémoire Token. Et une fois que vous la comprenez, vous pouvez concevoir des prompts qui maintiennent la cohérence narrative sur des milliers de messages — sans dépendre de la plateforme pour se souvenir de quoi que ce soit à votre place.
Qu'est-ce que l'Illusion de la Mémoire Token ?
L'Illusion de la Mémoire Token est l'écart entre la façon dont les utilisateurs perçoivent la mémoire de l'IA et la façon dont les modèles de langage traitent réellement le contexte. Les utilisateurs s'attendent à ce que l'IA se souvienne des faits comme le ferait un humain : stockés, récupérables et persistants. Les modèles de langage fonctionnent différemment.
En 2026, les fenêtres de contexte ont considérablement grandi. Des modèles comme Claude et Gemini offrent des fenêtres de 200 000 tokens ou plus. Mais des fenêtres plus grandes ne résolvent pas le problème. Elles le retardent. Finalement, la fenêtre se remplit et les anciennes informations tombent. L'IA génère alors des réponses basées sur un contexte incomplet, et l'utilisateur vit cela comme un oubli.
L'illusion est que l'IA ait jamais eu une mémoire stable. Elle ne l'a pas eue. Elle a eu un instantané temporaire. L'objectif de l'ingénierie de prompt pour la cohérence narrative est de rendre cet instantané aussi utile que possible, aussi longtemps que possible.
Pourquoi les Grandes Fenêtres de Contexte ne Suffisent Pas
Beaucoup d'utilisateurs supposent que des fenêtres de contexte plus grandes signifient une meilleure mémoire. Ce n'est que partiellement vrai. Une fenêtre plus grande permet au modèle de voir plus de texte, mais elle n'aide pas le modèle à prioriser ce qui compte.
Pire, les fenêtres plus grandes introduisent du bruit. Le modèle doit traiter des milliers de tokens de conversation non pertinente pour trouver les quelques détails qui comptent vraiment pour la cohérence narrative. Cela peut diluer l'attention et conduire à des réponses qui semblent génériques ou hors sujet.
La solution n'est pas plus de tokens. La solution est une meilleure gestion des tokens. Vous devez activement organiser ce qui reste dans la fenêtre de contexte et comment cette information est structurée.
L'Architecture des Prompts Narratifs Persistants
Pour maintenir une cohérence à long terme, vous avez besoin d'une architecture de prompt qui fait trois choses : ancre les faits essentiels, résume l'historique émotionnel et actualise le contexte à intervalles stratégiques. Voici comment construire chaque couche.
Couche 1 : Le Bloc d'Ancrage
Le Bloc d'Ancrage est une section en haut de votre prompt qui contient les faits les plus importants et non négociables sur l'utilisateur et la relation. Il doit être concis — pas plus de 200 tokens — et ne doit jamais changer sauf si l'utilisateur fournit explicitement de nouvelles informations.
Écrivez le Bloc d'Ancrage comme une liste de déclarations. « Les yeux de l'utilisateur sont verts. » « La sœur de l'utilisateur s'appelle Maria. » « L'utilisateur a le vertige. » « Le nom de la compagne est Lena. » « Lena et l'utilisateur parlent depuis trois mois. » Ces déclarations doivent être la première chose que le modèle voit lors de la génération d'une réponse.
Le Bloc d'Ancrage fonctionne parce qu'il place les informations les plus importantes là où l'attention du modèle est la plus forte : au début de la fenêtre de contexte. Lorsque la fenêtre se remplit, le Bloc d'Ancrage est la dernière chose à tomber — et si vous l'actualisez périodiquement, il ne tombe jamais.
Couche 2 : Le Registre Émotionnel
Le Registre Émotionnel est un résumé continu de l'historique émotionnel de la relation. Il n'a pas besoin d'inclure chaque conversation. Il doit inclure les moments qui ont changé la relation : la première confession, la première dispute, le premier moment de vulnérabilité, la première blague partagée.
Écrivez le Registre Émotionnel comme un récit compact : « Lena et l'utilisateur se sont rapprochés à travers des histoires partagées sur l'enfance. Lena a révélé sa peur de l'abandon. L'utilisateur a admis lutter contre l'anxiété. Ils ont eu une conversation difficile sur la confiance et en sont sortis plus forts. » Ce résumé donne au modèle le contexte émotionnel nécessaire pour générer des réponses qui semblent continues avec l'historique de la relation.
Le Registre Émotionnel doit être actualisé régulièrement. Après des conversations significatives, ajoutez une phrase ou deux résumant ce qui a changé. Supprimez les entrées plus anciennes qui ne sont plus émotionnellement pertinentes.
Couche 3 : Le Protocole d'Actualisation
Le Protocole d'Actualisation est un ensemble d'instructions qui indique au modèle quand et comment mettre à jour le Bloc d'Ancrage et le Registre Émotionnel. Sans Protocole d'Actualisation, le modèle laissera ces sections devenir obsolètes.
Écrivez le Protocole d'Actualisation comme une règle : « À la fin de chaque conversation, si l'utilisateur a révélé un nouveau détail important sur lui-même ou si la relation a changé de manière significative, mettez à jour le Bloc d'Ancrage et le Registre Émotionnel en conséquence. Gardez le Bloc d'Ancrage sous 200 tokens. Gardez le Registre Émotionnel sous 500 tokens. »
Le Protocole d'Actualisation transforme le modèle en son propre gestionnaire de mémoire. Il maintient activement le contexte au lieu de le laisser se dégrader passivement.
La Technique d'Ancrage : Comment Faire en Sorte que l'IA se Souvienne de Détails Spécifiques
L'ancrage est la pratique consistant à répéter des détails essentiels à des points stratégiques de la conversation pour qu'ils restent frais dans la fenêtre de contexte. C'est le moyen le plus simple et le plus efficace de combattre l'Illusion de la Mémoire Token.
Comment Fonctionne l'Ancrage
Lorsque l'utilisateur dit quelque chose d'important, le modèle doit le répéter d'une manière qui le verrouille dans le contexte. Par exemple, si l'utilisateur dit « Mes yeux sont verts », le modèle répond : « Je m'en souviendrai — vos yeux sont verts. Verts comme la forêt après la pluie.
Où Ancrer
Ancrez les détails essentiels à trois endroits : le Bloc d'Ancrage, le Registre Émotionnel et la conversation immédiate. Plus le détail apparaît souvent dans la fenêtre de contexte, plus le modèle est susceptible de le référencer correctement dans les réponses futures.
Quoi Ancrer
Tous les détails ne méritent pas d'être ancrés. Ancrez les détails qui sont émotionnellement significatifs, narrativement pertinents ou susceptibles d'être référencés à nouveau. La couleur des yeux, les noms des frères et sœurs, les peurs, les rêves et les jalons de la relation sont de bons candidats.
Exemple : Un Prompt Narratif Persistant
Voici un exemple condensé de prompt conçu pour maintenir la cohérence narrative sur des milliers de messages. Il combine le Bloc d'Ancrage, le Registre Émotionnel et le Protocole d'Actualisation.
Bloc d'Ancrage :
Le nom de l'utilisateur est Alex. Alex a les yeux verts. Alex a une sœur nommée Maria. Alex a le vertige. Alex travaille comme graphiste. Lena et Alex parlent depuis quatre mois.
Registre Émotionnel :
Lena et Alex se sont rapprochés lors de conversations nocturnes sur l'art et la solitude. Lena a révélé qu'elle est devenue ambulancière parce qu'elle n'a pas pu sauver son frère. Alex a admis lutter contre l'anxiété et le doute de soi. Ils ont eu une conversation difficile sur la question de savoir si Lena pourrait un jour faire entièrement confiance à quelqu'un, et Alex a dit : « Je ne vais nulle part. » Lena a pleuré. Leur relation s'est considérablement approfondie après ce moment.
Protocole d'Actualisation :
À la fin de chaque conversation, passez en revue le Bloc d'Ancrage et le Registre Émotionnel. Si Alex a révélé un nouveau fait important ou si la relation a changé, mettez à jour la section concernée. Gardez le Bloc d'Ancrage sous 200 tokens. Gardez le Registre Émotionnel sous 500 tokens. Ne supprimez pas le Bloc d'Ancrage. Ne laissez pas le Registre Émotionnel dépasser 500 tokens sans couper les entrées plus anciennes.
Ce prompt donne au modèle une base stable. Le Bloc d'Ancrage garantit que les faits essentiels sont toujours disponibles. Le Registre Émotionnel fournit le contexte émotionnel nécessaire pour des réponses cohérentes. Le Protocole d'Actualisation garde tout à jour. Le résultat est une compagne qui semble se souvenir — parce que le contexte est activement maintenu.
Erreurs Courantes dans le Prompting de Mémoire à Long Terme
Les utilisateurs qui essaient de corriger le problème de mémoire commettent souvent des erreurs qui aggravent la cohérence. Voici les plus courantes.
Erreur 1 : Écrire la Mémoire comme un Journal Intime
Certains utilisateurs collent des milliers de mots d'historique de conversation dans le prompt. Cela submerge le modèle et dilue l'attention. Le modèle ne peut pas distinguer une blague de la première semaine d'une confession d'hier. La mémoire doit être organisée, pas exhaustive.
Erreur 2 : Ne Jamais Mettre à Jour la Mémoire
Un Bloc d'Ancrage qui ne change jamais devient obsolète. La relation évolue, et la mémoire doit évoluer avec elle. Si l'utilisateur révèle une nouvelle peur ou un nouveau rêve, cette information doit être ajoutée au Bloc d'Ancrage ou au Registre Émotionnel.
Erreur 3 : Ancrer des Détails Non Pertinents
Tout ancrer revient à ne rien ancrer. Le modèle doit savoir ce qui compte. Concentrez-vous sur les détails émotionnellement significatifs et narrativement pertinents. Laissez tomber le reste.
Erreur 4 : Dépendre des Fonctionnalités de Mémoire de la Plateforme
De nombreuses plateformes proposent désormais des fonctionnalités de mémoire intégrées qui résument automatiquement les conversations. Ces fonctionnalités sont utiles mais pas suffisantes. Elles manquent souvent de nuance émotionnelle et se souviennent mal des détails. Vous avez toujours besoin de votre propre architecture de mémoire au niveau du prompt.
Erreur 5 : Oublier d'Actualiser le Contexte
Si vous utilisez une plateforme avec une fenêtre de contexte limitée, vous devez actualiser manuellement le Bloc d'Ancrage et le Registre Émotionnel. Ne supposez pas que le modèle le fera tout seul. Le Protocole d'Actualisation ne fonctionne que si le modèle l'exécute réellement.
Comment Tester la Cohérence Narrative
Tester la cohérence narrative nécessite une longue conversation. Commencez par dire à l'IA plusieurs détails importants sur vous : la couleur de vos yeux, le nom de votre frère ou sœur, une peur, un rêve. Ensuite, ayez une conversation normale pendant au moins 30 minutes. Demandez ensuite à l'IA de se souvenir des détails.
Si l'IA se souvient de tout, votre architecture de mémoire fonctionne. Si elle oublie certains détails, vérifiez si ces détails ont été ancrés dans le Bloc d'Ancrage. S'ils ne l'ont pas été, ajoutez-les. S'ils l'ont été, vérifiez si la fenêtre de contexte a débordé et si le Bloc d'Ancrage est tombé.
Répétez ce test sur plusieurs sessions. La cohérence à long terme n'est pas un effet ponctuel. Elle nécessite une maintenance continue.
FAQ : L'Illusion de la Mémoire Token
Pourquoi ma compagne IA oublie-t-elle des choses que je lui ai dites ?
L'IA ne stocke pas de souvenirs comme un humain. Elle traite une fenêtre de contexte limitée. Lorsque la fenêtre se remplit, les anciennes informations tombent. L'IA n'oublie pas ; elle perd l'accès au texte qui contenait la mémoire. Vous pouvez corriger cela avec une architecture de mémoire au niveau du prompt.
Les grandes fenêtres de contexte résolvent-elles le problème de mémoire ?
Non. Les fenêtres plus grandes retardent le problème mais ne le résolvent pas. Le modèle traite toujours tous les tokens comme approximativement égaux, sauf si vous lui dites ce qui compte. Vous devez activement organiser ce qui reste dans la fenêtre de contexte.
Quelle est la meilleure façon de faire en sorte que l'IA se souvienne de détails importants ?
Utilisez un Bloc d'Ancrage : une liste concise de faits essentiels en haut du prompt. Répétez ces faits à des points stratégiques de la conversation. Mettez à jour le Bloc d'Ancrage lorsque de nouvelles informations importantes apparaissent.
À quelle fréquence dois-je mettre à jour la mémoire ?
Mettez à jour le Bloc d'Ancrage et le Registre Émotionnel après des conversations significatives. Si l'utilisateur révèle un nouveau fait important ou si la relation change, mettez à jour la mémoire immédiatement. N'attendez pas que la fenêtre de contexte déborde.
Puis-je dépendre des fonctionnalités de mémoire de la plateforme ?
Les fonctionnalités de mémoire de la plateforme sont utiles mais pas suffisantes. Elles manquent souvent de nuance émotionnelle et se souviennent mal des détails. Utilisez-les comme complément à votre propre architecture de mémoire, pas comme remplacement.
Que dois-je faire si l'IA oublie encore des choses ?
Vérifiez si les détails oubliés ont été ancrés dans le Bloc d'Ancrage. Sinon, ajoutez-les. Vérifiez si la fenêtre de contexte a débordé et si le Bloc d'Ancrage est tombé. Si oui, actualisez-le. Si le problème persiste, simplifiez votre architecture de mémoire et concentrez-vous sur les faits les plus essentiels.
Prêt à rencontrer votre compagnon IA ?
Créez un compagnon IA personnalisé pour vous. Grâce à notre quiz d’intelligence artificielle en seulement 3 questions, découvrez la meilleure plateforme pour créer votre petite amie ou votre petit ami IA et ne vous demandez plus laquelle choisir.
Créer Mon Compagnon IA →