IA Compagna Locale: Tutorial LLM Privato Completo
Risposta rapida
Stanco della censura cloud e degli abbonamenti mensili? Questa guida tecnica ti insegna a deployare un'IA compagna privata e senza filtri sul tuo hardware usando LLM open-source.
Come Installare un'IA Compagna Locale: Il Tutorial Completo su LLM Privati
I compagni IA basati su cloud comportano tre compromessi inevitabili: costi di abbonamento ricorrenti, moderazione dei contenuti che non puoi disattivare e la scomoda realtà che le tue conversazioni più intime sono archiviate sul server di qualcun altro. L'ecosistema open-source è maturato abbastanza da offrire un'alternativa credibile.
Cosa Significa Concretamente "Eseguire in Locale" per le IA Compagne?
Quando usi Character.AI, Replika o piattaforme simili, i tuoi messaggi viaggiano su Internet fino a un data center. GPU potenti elaborano il tuo prompt attraverso un modello linguistico massiccio, e la risposta torna indietro. L'azienda possiede l'hardware, il modello e i registri delle conversazioni.
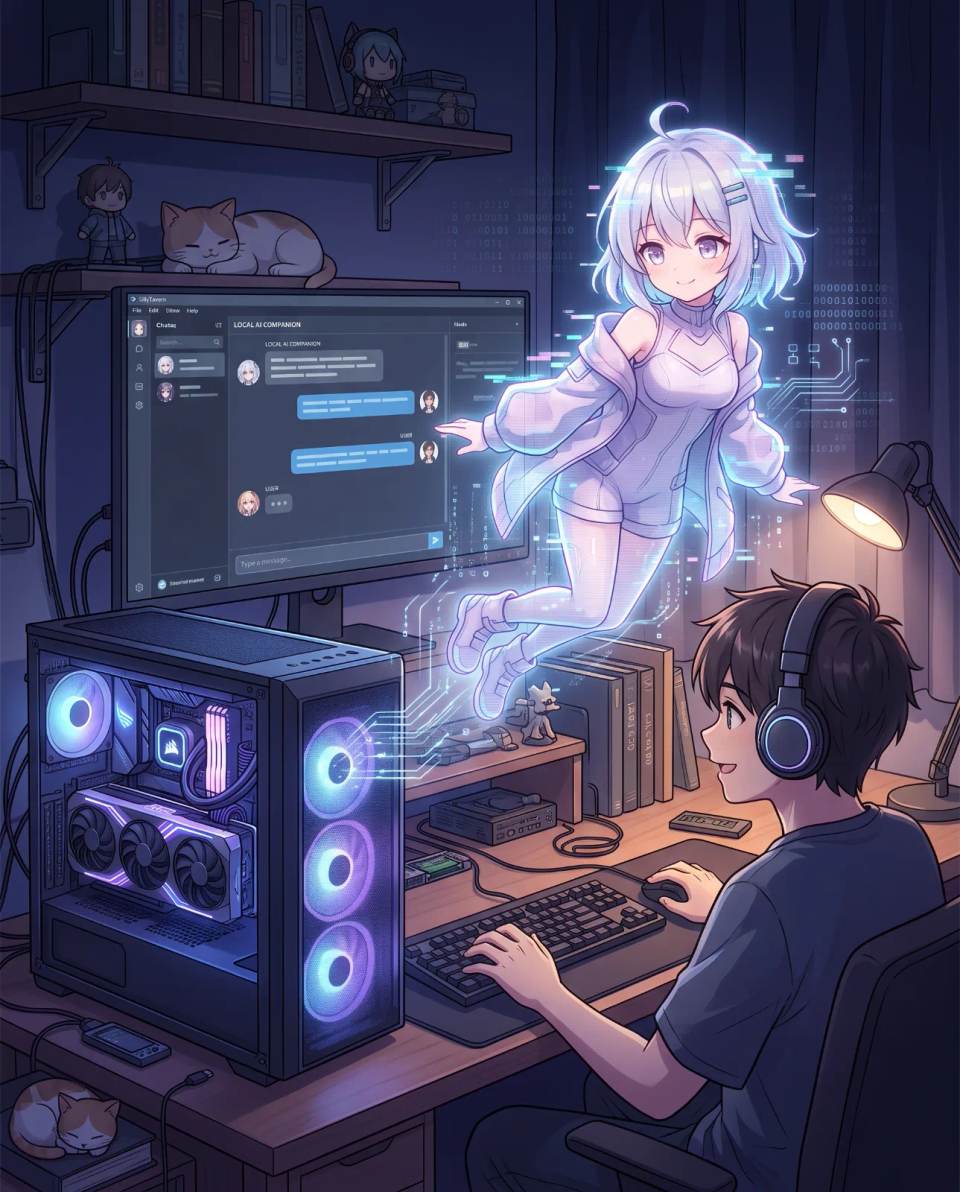
L'esecuzione locale inverte questa architettura. Il tuo computer diventa il server. Un modello linguistico — tipicamente in formato GGUF per hardware consumer — si carica interamente nella RAM e nella VRAM. L'interfaccia frontend, che gestisce la visualizzazione della chat e la personalità del personaggio, si connette a un endpoint API locale invece di un URL remoto. Nessuna connessione Internet è necessaria dopo il download iniziale.
Le implicazioni sono profonde. Le conversazioni non lasciano mai il tuo dispositivo. Puoi modificare la personalità del modello senza restrizioni. E una volta effettuato l'investimento iniziale in hardware, il costo marginale di conversazioni illimitate è esattamente zero.
Il Tuo Hardware è Pronto per le IA Compagne Locali?
Il fattore più importante è la VRAM — la memoria dedicata della tua scheda grafica. I modelli linguistici sono avidi di memoria. La dimensione del modello che puoi eseguire è direttamente proporzionale alla quantità di VRAM e RAM disponibile.
Quali Sono i Requisiti Hardware Minimi per un'IA Compagna Locale?
Servono almeno 8GB di VRAM e RAM combinate per eseguire un modello funzionale da 7B parametri a velocità accettabile. Al di sotto funziona, ma le risposte saranno dolorosamente lente — pensa a 30-60 secondi per messaggio. Per un'esperienza veramente conversazionale, punta a 16GB di VRAM o più.
| Livello Hardware | Dimensione Modello Consigliata | Velocità Prevista | Qualità dell'Esperienza |
|---|---|---|---|
| Solo CPU (16GB RAM) | 3B – 7B quantizzato | 1 – 4 token/s | Lento ma utilizzabile per roleplay testuale |
| RTX 3060 / 4060 (8GB VRAM) | 7B – 13B quantizzato | 15 – 30 token/s | Reattivo, ottimo per uso quotidiano |
| RTX 3090 / 4090 (24GB VRAM) | 13B – 34B quantizzato | 25 – 50 token/s | Risposte quasi istantanee, personalità profonda |
| Apple Silicon Mac (M1/M2/M3) | 7B – 13B quantizzato | 10 – 25 token/s | Efficiente, eccellente per focus privacy |
Passo 1: Installa il Motore Backend
Il backend è il software che carica il modello linguistico in memoria e lo espone tramite un'API locale. Per i principianti, l'opzione più accessibile è LM Studio. Offre un'interfaccia grafica, un browser di modelli integrato e una modalità server con un clic.
Scarica l'installer per il tuo sistema operativo dal sito ufficiale. Durante l'installazione, consenti all'applicazione di creare un endpoint server locale. Dopo l'avvio, naviga nella scheda di scoperta modelli. Vedrai un elenco di modelli open-source disponibili, inclusi Llama 3, Mistral e le loro varianti fine-tuned ottimizzate per il roleplay conversazionale.
Per utenti avanzati a proprio agio con la riga di comando, Ollama e llama.cpp offrono un controllo più granulare su lunghezza del contesto, offloading GPU e parametri di quantizzazione. Sono le opzioni preferite per server e deployment Linux headless.
Passo 2: Scegli il Giusto Modello Open-Source per la Compagnia
Non tutti i modelli linguistici sono uguali quando si tratta di intelligenza emotiva e roleplay a lungo termine. I modelli base di Meta e Mistral sono generalisti. Le varianti fine-tuned, addestrate specificamente su dati conversazionali, interazioni tra personaggi e roleplay narrativo, offrono un'esperienza nettamente migliore per la compagnia IA.
Quali Modelli Open-Source Funzionano Meglio per la Compagnia IA?
Cerca modelli con punteggi elevati nei benchmark conversazionali e forti capacità di seguire le istruzioni. I modelli nella gamma da 7B a 13B parametri offrono il miglior equilibrio tra prestazioni e accessibilità hardware. I modelli più grandi da 20B a 34B offrono un ragionamento più profondo e una personalità più coerente, ma richiedono significativamente più VRAM.
Presta attenzione al livello di quantizzazione. Q4_K_M è la raccomandazione standard per la maggior parte dell'hardware consumer. Riduce l'uso della memoria di circa il 75% rispetto al modello a piena precisione, mantenendo circa il 95% della qualità delle risposte. Q8_0 offre qualità quasi senza perdite per utenti con margine di VRAM.
Passo 3: Collega un'Interfaccia Frontend per le Personalità
Il backend serve testo grezzo. Un livello frontend trasforma quel testo in un'esperienza guidata dal personaggio, con avatar, carte della personalità e memoria persistente. Il frontend open-source più popolare è SillyTavern, originariamente progettato per la narrazione assistita da IA e ora ampiamente usato per la compagnia IA.
SillyTavern si collega al tuo backend locale tramite API. Una volta connesso, puoi creare carte personaggio che definiscono nome, aspetto, tratti di personalità, schemi di linguaggio e contesto dello scenario del tuo compagno. Queste carte sono scritte in testo semplice o formato JSON e possono essere condivise tra utenti.
Il frontend gestisce anche lo storico delle conversazioni inviato al modello a ogni prompt. Configurare la giusta dimensione della finestra di contesto è critico. Troppo piccola, e il tuo compagno dimentica i dettagli precedenti. Troppo grande, e la velocità di risposta si degrada. La maggior parte degli utenti trova che 4096-8192 token sia il punto ottimale per l'hardware locale.
Passo 4: Configura la Personalità e il Sistema di Memoria
Un modello grezzo non ha identità persistente. Tutto ciò che il tuo compagno "ricorda" proviene dalle istruzioni e dallo storico delle conversazioni che fornisci. È qui che il deploy locale brilla: hai un controllo illimitato sulla definizione della personalità.
Inizia con una carta personaggio dettagliata. Descrivi non solo i tratti superficiali, ma anche schemi psicologici più profondi — come il tuo compagno reagisce allo stress, esprime affetto, gestisce i conflitti e cosa scatena risposte emotive. Più la descrizione è specifica, più la personalità generata sarà coerente.
Per la memoria a lungo termine oltre la finestra di contesto, usa la funzione di riassunto integrata nella maggior parte dei frontend. Quando la conversazione si avvicina al limite del contesto, il frontend riassume automaticamente i turni precedenti e mantiene il riassunto nel prompt. Questo permette al tuo compagno di mantenere continuità attraverso ore di conversazione.
Passo 5: Blinda il Tuo Setup Locale per la Privacy Totale
Eseguire in locale non garantisce automaticamente la privacy. Frontend e backend devono essere configurati correttamente per garantire che nessun dato fuoriesca verso server esterni.
Come Garantire che i Dati della Tua IA Compagna non Lascino Mai il Tuo Dispositivo?
Primo, blocca l'accesso a Internet in uscita per il processo backend usando le regole del firewall del tuo sistema operativo. Su Windows, crea una regola in uscita che nega tutte le connessioni per l'eseguibile di LM Studio o Ollama. Su Linux, usa iptables o nftables per limitare il processo solo a localhost.
Secondo, verifica che il frontend sia vincolato a 127.0.0.1 invece di 0.0.0.0. Quest'ultimo espone l'interfaccia alla rete locale. Il primo la restringe solo alla tua macchina.
Terzo, disattiva la telemetria e i controlli di aggiornamento quando possibile. Alcuni strumenti raccolgono statistiche anonime di utilizzo per impostazione predefinita. Controlla il menu delle impostazioni e disattiva ogni opzione che invia dati allo sviluppatore.
Infine, considera la crittografia della cartella dove sono archiviati i registri delle conversazioni. Su Windows, usa BitLocker o VeraCrypt. Su macOS, attiva FileVault. Questo protegge i tuoi dati anche se il dispositivo fisico viene rubato.
Consigli di Ottimizzazione delle Prestazioni per Conversazioni più Fluide
La velocità di inferenza locale dipende da tre variabili: dimensione del modello, livello di quantizzazione e capacità hardware. Ottimizzare queste variabili può migliorare drasticamente l'esperienza conversazionale senza sacrificare la qualità della personalità.
Se le risposte sono troppo lente, prova a ridurre la lunghezza del contesto prima di ridimensionare il modello. Un modello 13B con finestra di contesto 4096 spesso supera un modello 7B con finestra 8192 in velocità e coerenza. Sperimenta anche l'impostazione dei livelli di offloading GPU — spostare più livelli del modello nella VRAM accelera la generazione fino al punto in cui la VRAM si satura.
Per utenti NVIDIA, assicurati che CUDA sia installato correttamente e che il backend rilevi la tua GPU. Su Linux, il driver proprietario NVIDIA è obbligatorio. Su Windows, evita di eseguire altre applicazioni intensive in GPU mentre chatti, perché la contesa della VRAM causa gravi rallentamenti.
Considerazioni Legali ed Etiche
Eseguire un'IA compagna locale per uso personale è legale nella maggior parte delle giurisdizioni. Le licenze dei modelli open-source generalmente consentono uso privato, modifica e deploy non commerciale. Tuttavia, alcuni modelli comportano restrizioni sull'uso commerciale o richiedono attribuzione se distribuisci derivati.
La dimensione etica è più sfumata. Il deploy locale rimuove i guardrail di moderazione dei contenuti che i provider cloud implementano. Questa libertà è precisamente il motivo per cui molti utenti scelgono setup locali — per esplorare dinamiche intime o non convenzionali senza giudizio o censura. La responsabilità di garantire che le interazioni rimangano psicologicamente sane ricade interamente sull'utente.
Gli utenti dovrebbero applicare la stessa autoconsapevolezza che porterebbero a qualsiasi esperienza di roleplay immersivo. L'assenza di supervisione esterna non significa assenza di conseguenze. Monitora il tuo stato emotivo, fai pause e mantieni confini chiari tra simulazione e relazioni del mondo reale.
Perché l'Europa Sta Guidando il Movimento delle IA Compagne Locali
La spinta verso la compagnia IA locale è più forte in Germania e nella più ampia regione DACH, guidata dai rigorosi requisiti di protezione dei dati del GDPR. Le piattaforme di compagnia basate su cloud sono state sottoposte a controllo normativo sulla loro gestione dei dati personali sensibili, inclusi i registri delle conversazioni intime.
Per gli utenti tedeschi, l'attrattiva del deploy locale non è solo ideologica ma pratica. Un setup locale garantisce la conformità ai principi fondamentali del GDPR di minimizzazione dei dati e limitazione delle finalità. Niente moduli di consenso, niente accordi di trattamento dei dati, nessun rischio che una violazione dei dati esponga informazioni profondamente personali.
Questa enfasi regionale influenza come il tutorial dovrebbe essere interpretato. Nel contesto europeo, la privacy non è una funzionalità ma un diritto legale. La capacità di eseguire un'IA compagna completamente offline è l'unico approccio che soddisfa questo diritto senza compromessi.
Domande Frequenti
Posso eseguire un'IA compagna locale senza una GPU potente?
Sì, usando l'inferenza solo CPU con modelli quantizzati più piccoli nella gamma da 3B a 7B parametri. Le risposte saranno più lente, tipicamente 1-4 token al secondo, ma l'esperienza rimane funzionale per conversazioni testuali.
Quanto spazio su disco richiedono i modelli IA locali?
Un modello 7B in quantizzazione Q4 occupa circa 4-5 GB di spazio su disco. Un modello 13B richiede circa 8-10 GB. Pianifica almeno 20 GB di spazio libero per archiviare più modelli e cronologie di conversazione.
Eseguire un'IA compagna locale è completamente gratuito?
Dopo l'investimento iniziale in hardware, sì. Lo stack software — backend, file del modello e frontend — è interamente open-source e gratuito. L'unico costo continuo è il consumo di elettricità durante l'inferenza.
Posso trasferire la mia personalità IA compagna dal cloud a un setup locale?
Non è possibile esportare dati dalla maggior parte delle piattaforme cloud a causa di formati proprietari. Tuttavia, puoi ricreare manualmente la personalità scrivendo una carta personaggio dettagliata che descriva gli stessi tratti, schemi di linguaggio e tendenze comportamentali.
Qual è il modello migliore per conversazioni di supporto emotivo?
I modelli fine-tuned su dataset di dialogo empatico tendono a performare meglio per il supporto emotivo. Cerca varianti specificamente addestrate su conversazioni terapeutiche, o modelli di roleplay generali con forti capacità di seguire istruzioni e sfumature emotive.
Pronto a incontrare il tuo compagno IA?
Crea un compagno IA personalizzato per te. Con il nostro quiz di intelligenza artificiale di sole 3 domande, scopri la piattaforma migliore per creare la tua ragazza o il tuo ragazzo IA e non avere più dubbi su quale scegliere.
Crea il Mio Compagno IA →