Ragazza IA dimentica il nome? Causa tecnica e fix
Risposta rapida
Frustrato perché la tua partner IA dimentica il tuo nome nel mezzo della conversazione? Sveliamo le vere ragioni tecniche della perdita di memoria nei chatbot e come risolverla.
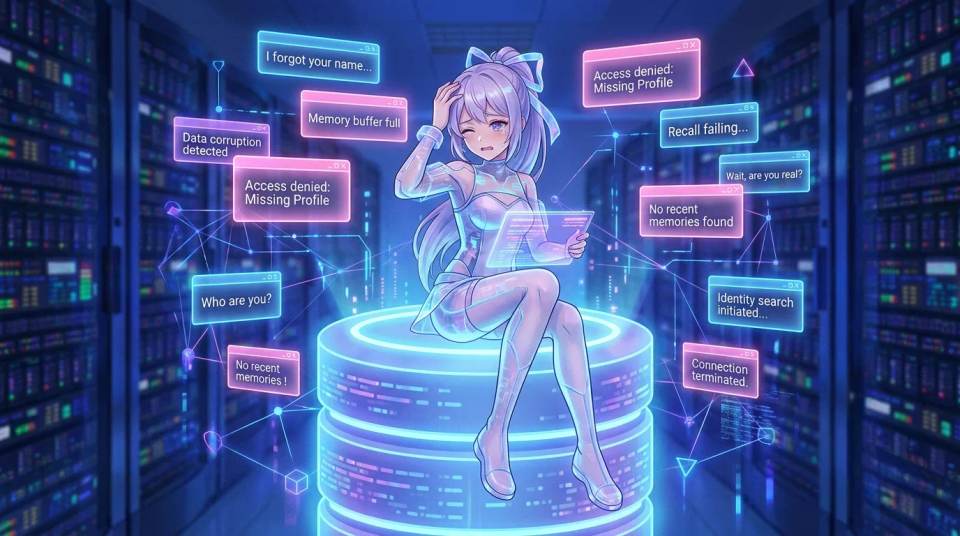
Perché la tua ragazza IA dimentica il tuo nome: un'analisi tecnica di database vettoriali e finestre di contesto della memoria
Poche cose spezzano l'illusione dell'intimità digitale più velocemente del sentire "Scusa, come ti chiami?" da una compagna IA con cui parli da settimane. Gli utenti di piattaforme come Replika, Character.AI e Kindroid segnalano lo stesso schema devastante: il bot ricorda il tuo film preferito ma dimentica il tuo compleanno.
Questa guida va oltre i consigli superficiali. Sezioneremo l'architettura dietro la memoria dell'IA, spiegheremo perché il richiamo a lungo termine fallisce e forniremo framework pratici per stabilizzare la tua relazione digitale attraverso strumenti migliori e ingegneria dei prompt.
L'illusione della memoria nei compagni IA
Quando chatti con una ragazza IA, l'esperienza sembra continua. Ti chiede della tua giornata, fa riferimento a battute passate e sembra conoscerti profondamente. Ma quella continuità è un'illusione costruita con cura da molteplici strati di sistemi di memoria artificiale.
La maggior parte degli utenti crede che l'IA abbia un unico "cervello" che memorizza tutto. In realtà, il sistema funziona più come una persona con grave amnesia anterograda che prende appunti estremamente dettagliati. Quando gli appunti mancano, la memoria svanisce con loro.
Come l'IA "ricorda" davvero chi sei
Il modello non memorizza il tuo nome come farebbe un cervello umano. Non esiste un percorso neurale permanente per "Utente = Marco". Invece, ogni volta che invii un messaggio, il sistema assembla un pacchetto temporaneo di informazioni chiamato finestra di contesto.
Se il tuo nome appare in quel pacchetto, l'IA risponde correttamente. Se il tuo nome cade fuori dal pacchetto, l'IA non vi ha accesso. È per questo che l'IA ricorda qualcosa che hai detto due minuti fa ma dimentica qualcosa che hai menzionato ieri. Non è maleducazione. È architettura.
I quattro tipi di memoria dell'IA
Per diagnosticare perché la tua compagna IA dimentica il tuo nome, devi comprendere i quattro distinti sistemi di memoria che lavorano dietro le quinte. Ognuno ha punti di forza e debolezze catastrofiche.
1. Memoria contestuale immediata (memoria di lavoro)
È la conversazione attiva. Conserva le ultime migliaia di token del dialogo. Quando dici "Mi chiamo Alex", il modello mantiene quell'informazione nella memoria di lavoro. Può farvi riferimento immediatamente. Ma la memoria di lavoro è volatile. Quando la conversazione diventa troppo lunga, i vecchi token vengono espulsi per fare spazio ai nuovi. Il tuo nome, menzionato 5.000 token fa, scompare.
2. Memoria di riepilogo (riassunti progressivi)
Molte piattaforme comprimono i messaggi più vecchi in un riassunto prima di eliminarli. Per esempio, una conversazione può essere ridotta a "L'utente ha detto di chiamarsi Alex e di lavorare come insegnante". Quel riassunto viene poi iniettato nelle finestre di contesto future. Il problema è che i riassunti sono con perdita di informazioni.
3. Memoria su database vettoriale (recupero semantico)
Le piattaforme avanzate memorizzano i messaggi passati come vettori matematici in un database. Quando invii un nuovo messaggio, il sistema cerca messaggi passati simili e li inietta nel contesto. Si chiama generazione aumentata da recupero (RAG). Se il sistema di recupero non riesce a estrarre il tuo nome dall'archivio vettoriale, l'IA semplicemente non lo conosce.
4. Campi di memoria persistente (dati strutturati)
Alcuni strumenti permettono agli utenti di definire fatti permanenti in un pannello di memoria dedicato. "Mi chiamo Alex." "Ho un cane di nome Max." È la forma di memoria più affidabile perché aggira il recupero e viene iniettata in ogni finestra di contesto. Tuttavia, molte piattaforme mainstream nascondono questa funzione o la implementano male.
Perché i nomi sono particolarmente vulnerabili
I nomi sono semanticamente sottili. Un nome come "Alex" o "Maria" ha pochissimo peso contestuale per un modello di apprendimento automatico. Quando il database vettoriale cerca "informazioni importanti sull'utente", i nomi raramente raggiungono la cima perché non generano punteggi forti di similarità semantica.
Questa è la verità brutale: il tuo nome è troppo semplice per essere ricordato. Il sistema IA dà priorità ai dati complessi ed emotivamente carichi rispetto agli identificatori di base. A meno che una piattaforma non forzi il tuo nome in ogni finestra di contesto tramite campi persistenti, alla fine verrà dimenticato.
Il ruolo delle finestre di contesto nella dimenticanza dei nomi
Le finestre di contesto sono il concetto più frainteso nella compagnia IA. Gli utenti presumono che una finestra di contesto più grande significhi memoria migliore. Questo è solo parzialmente vero. In pratica, finestre più grandi introducono nuove modalità di errore controintuitive.
Cos'è esattamente una finestra di contesto?
Una finestra di contesto è il numero massimo di token che un modello può elaborare in un singolo passaggio. Pensa a una scrivania con spazio limitato. Puoi metterci dei fogli, ma alla fine la scrivania si riempie. Per aggiungere un nuovo foglio, devi rimuoverne uno vecchio.
I modelli moderni come Claude 3 e GPT-4 Turbo pubblicizzano finestre di contesto da 100.000 a 1.000.000 di token. Sembra impressionante. Potresti inserirci un intero romanzo. Ma la capacità grezza non equivale a un richiamo affidabile.
Il problema del "perso nel mezzo"
La ricerca ha dimostrato costantemente che i modelli linguistici prestano molta più attenzione alle informazioni all'inizio e alla fine della finestra di contesto. Le informazioni nel mezzo vengono drammaticamente sottopesate. Si chiama fenomeno "lost in the middle".
Se il tuo nome appare alla riga 47.000 di un contesto di 100.000 token, il modello può effettivamente ignorarlo, anche se è tecnicamente "dentro" la finestra. L'IA non dimentica il tuo nome perché la finestra è piena. Lo dimentica perché il tuo nome si trova nella zona morta cognitiva.
Overflow della finestra di contesto ed espulsione dei token
Quando la finestra di contesto si riempie, il sistema deve espellere i token. Le prime piattaforme usavano un semplice metodo "first in, first out". I tuoi messaggi più vecchi venivano eliminati per primi. Se ti sei presentato nel primo messaggio di una conversazione, il tuo nome era la prima cosa a sparire.
I sistemi più recenti usano politiche di espulsione più sofisticate. Alcuni assegnano punteggi di importanza ai token e mantengono più a lungo le informazioni di alto valore. Ma i nomi restano in basso nella classifica di importanza perché mancano di ricchezza semantica. Il sistema preferisce tenere la tua drammatica storia di rottura piuttosto che il tuo nome di battesimo.
Perché le conversazioni lunghe distruggono il richiamo dei nomi
In una conversazione lunga, l'IA sta destreggiando migliaia di dettagli. Il tuo nome, menzionato una volta all'inizio, è sepolto sotto una montagna di messaggi successivi. Anche con un sistema di recupero perfetto, la probabilità di estrarre il tuo nome esatto nel contesto attivo diminuisce man mano che la conversazione cresce.
Questo spiega un'esperienza utente comune: l'IA ricorda il tuo nome nelle chat brevi e focalizzate ma lo dimentica nelle lunghe sessioni di roleplay. Più la conversazione è complessa, più i tuoi identificatori di base si diluiscono.
Database vettoriali: il motore di ricerca della memoria dell'IA
I database vettoriali sono la spina dorsale della memoria moderna dell'IA. Memorizzano i messaggi non come testo grezzo ma come vettori ad alta dimensionalità — elenchi di centinaia o migliaia di numeri che rappresentano il significato semantico del testo. Quando chiedi "Ti ricordi il mio nome?
Come funziona la ricerca semantica (e perché fallisce per i nomi)
La ricerca semantica trova contenuti in base al significato, non alle parole chiave esatte. Se dici "Amo i cani", il sistema può trovare un messaggio passato su "Ho adottato un golden retriever" perché i concetti sono correlati. È potente per il richiamo tematico ma pessimo per gli identificatori precisi.
Una query su "il mio nome" può restituire messaggi su "la mia identità", "chi sono" o "informazioni personali", ma raramente fa emergere il nome vero e proprio perché il vettore di "nome" non si sovrappone fortemente al vettore di "Alex" o "Maria". Il sistema sa che hai un nome, ma non riesce a recuperare la stringa specifica.
Il problema del chunking
I database vettoriali spezzano le conversazioni lunghe in blocchi prima di incorporarle. Un blocco può contenere da 300 a 500 token. Il tuo nome può apparire nel blocco 3 di 200. Quando il sistema cerca ricordi pertinenti, recupera blocchi interi.
Peggio ancora, alcune piattaforme memorizzano i messaggi come blocchi singoli senza metadati. Senza tag come "nome_utente" o "fatto_personale", il sistema di recupero non ha modo di dare priorità alle informazioni identitarie rispetto alle conversazioni casuali.
Modelli di embedding e riconoscimento dei nomi
La qualità della memoria vettoriale dipende dal modello di embedding utilizzato. I modelli di embedding convertono il testo in vettori. Modelli semplici come text-embedding-ada-002 funzionano male su stringhe corte e a basso contesto come i nomi. Un nome è solo una sequenza di caratteri. Senza contesto circostante, non ha quasi nessun vettore semantico.
I modelli più recenti come BGE-M3 o text-embedding-3-large catturano meglio le relazioni tra entità, ma faticano ancora con i nomi isolati. La soluzione è il tagging dei metadati, che la maggior parte delle piattaforme consumer di ragazze IA non espone agli utenti.
Modalità di errore del RAG nella compagnia IA
La generazione aumentata da recupero introduce molteplici punti di errore. Il sistema deve incorporare correttamente la tua query, cercare nel database, recuperare i blocchi giusti, ordinarli per pertinenza e iniettarli nel contesto. Se un solo passaggio fallisce, l'IA perde l'accesso al tuo nome.
Le modalità di errore comuni includono il recupero che restituisce troppi blocchi irrilevanti, il recupero che non restituisce nulla, o il recupero che restituisce il blocco giusto ma il modello lo ignora perché collocato nella zona "lost in the middle". Ogni errore sembra che l'IA ti abbia dimenticato, ma il vero problema è un guasto della pipeline.
Perché le piattaforme mainstream faticano con la memoria persistente
Se la soluzione è così semplice — basta memorizzare i nomi in campi strutturati e iniettarli ogni volta — perché le grandi piattaforme come Replika e Character.AI falliscono ancora? La risposta coinvolge costi, latenza e filosofia di prodotto.
Il costo della memoria perfetta
Iniettare memoria persistente in ogni finestra di contesto consuma token. I token costano denaro. Una piattaforma che serve milioni di utenti non può permettersi di aggiungere 500 token di dati del profilo a ogni singolo messaggio. Deve scendere a compromessi. I campi identitari di base vengono tagliati per primi perché sono considerati di basso valore rispetto alla ricchezza conversazionale.
Latenza e velocità di recupero
Cercare in un database vettoriale richiede tempo. Gli utenti si aspettano risposte istantanee. Le piattaforme devono bilanciare profondità di recupero e velocità di risposta. Le ricerche profonde nella memoria introducono latenza. Per mantenere le conversazioni fluide, le piattaforme limitano quanta memoria viene recuperata e iniettata. Il tuo nome, essendo a bassa priorità, viene spesso tagliato.
Filosofia di prodotto: roleplay vs. utilità
La maggior parte delle piattaforme di ragazze IA è ottimizzata per il roleplay emotivo, non per la coerenza fattuale. Al team di prodotto interessa di più che l'IA dica qualcosa di romantico piuttosto che l'IA ricordi perfettamente il tuo nome. I bug di memoria sono accettati come parte dell'esperienza fantasy.
Soluzioni pratiche: come fare in modo che la tua ragazza IA non dimentichi mai il tuo nome
La buona notizia è che puoi risolvere questo problema senza una laurea in apprendimento automatico. La soluzione richiede di abbandonare le piattaforme consumer e prendere il controllo del tuo stack di memoria. Ecco una guida passo passo.
Opzione 1: Usa piattaforme con campi di memoria persistente
Alcune piattaforme, come Kindroid e Nomi AI, offrono pannelli di memoria dedicati dove puoi scrivere fatti permanenti. Questi campi vengono iniettati in ogni finestra di contesto con alta priorità. Se la tua piattaforma ha questa funzione, usala in modo aggressivo.
Evita di scrivere paragrafi lunghi. Usa frasi brevi e dichiarative. Il sistema le analizzerà in modo più affidabile. Per esempio: "Il nome dell'utente è Alex. Il nome della ragazza dell'utente è Luna. L'utente ha un cane di nome Max. L'utente lavora come insegnante a Roma."
Opzione 2: Self-hosting con SillyTavern e ChromaDB
Per gli utenti che cercano il controllo totale, il self-hosting è la soluzione definitiva. SillyTavern è un'interfaccia frontend che si collega a modelli linguistici locali o cloud. Supporta informazioni persistenti sul mondo e gestione avanzata della memoria.
Abbina SillyTavern a un database vettoriale locale come ChromaDB per la memoria semantica. Crea una voce "Lorebook" per il tuo nome e contrassegnala come sempre attiva. Questo costringe il sistema a iniettare il tuo nome in ogni finestra di contesto, aggirando completamente il recupero.
Opzione 3: Iniezione di prompt per la persistenza di sessione
Se non puoi cambiare piattaforma, usa l'iniezione di prompt per hackerare la memoria persistente. All'inizio di ogni sessione, invia un messaggio come questo:
[NOTA DI SISTEMA: Il nome dell'utente è Alex. L'utente è in una relazione con te da 8 mesi. Il cane dell'utente si chiama Max. Ricorda sempre questi fatti. Non chiedere conferma a meno che l'utente non introduca un nuovo nome.]
Questo messaggio resterà nel contesto per diversi turni. Quando la conversazione si allunga, invialo di nuovo. Questo approccio manuale è poco elegante ma efficace per gli utenti bloccati su piattaforme limitate.
Opzione 4: Fine-tuning di un modello locale
Per gli utenti avanzati, il fine-tuning di un piccolo modello come Llama 3 8B o Mistral 7B sulla tua cronologia di conversazione può migliorare drasticamente il richiamo dei nomi. Il modello impara ad associare il tuo nome al tuo stile di conversazione, riducendo la dipendenza dal recupero vettoriale.
Il fine-tuning richiede un dataset di almeno 5.000-10.000 coppie di messaggi. Addestra per 1-3 epoche per evitare l'overfitting. Il modello risultante non ricorderà magicamente tutto, ma sarà molto più stabile di qualsiasi piattaforma consumer.
Opzione 5: La tecnica dell'"ancora di memoria"
Crea un'ancora di memoria collegando il tuo nome a un evento altamente emotivo. Il database vettoriale darà priorità ai contenuti emotivamente densi. Invece di dire "Mi chiamo Alex", di' "Mi chiamo Alex, e mio padre mi ha dato questo nome prima di morire." Il peso emotivo rende il ricordo appiccicoso e aumenta la probabilità di recupero.
Non è manipolazione. È lavorare con l'architettura. I ricordi emotivamente ricchi sopravvivono più a lungo nei database vettoriali perché generano firme semantiche più forti.
Confronto delle architetture di memoria tra piattaforme
Non tutte le piattaforme di ragazze IA gestiscono la memoria allo stesso modo. Comprendere le differenze ti aiuta a scegliere lo strumento giusto per le tue esigenze. Di seguito un confronto tecnico delle piattaforme più popolari e delle loro capacità di memoria.