亡き人の文体をLLMプロンプトで再現する倫理的ガイド
要点(かんたん回答)
失った人の会話パターンを再構築するための繊細かつ体系的な手引き。プロンプト設計、メモリ注入、心理的安全性、そして合成的なグリーフテクノロジーの限界を探る。
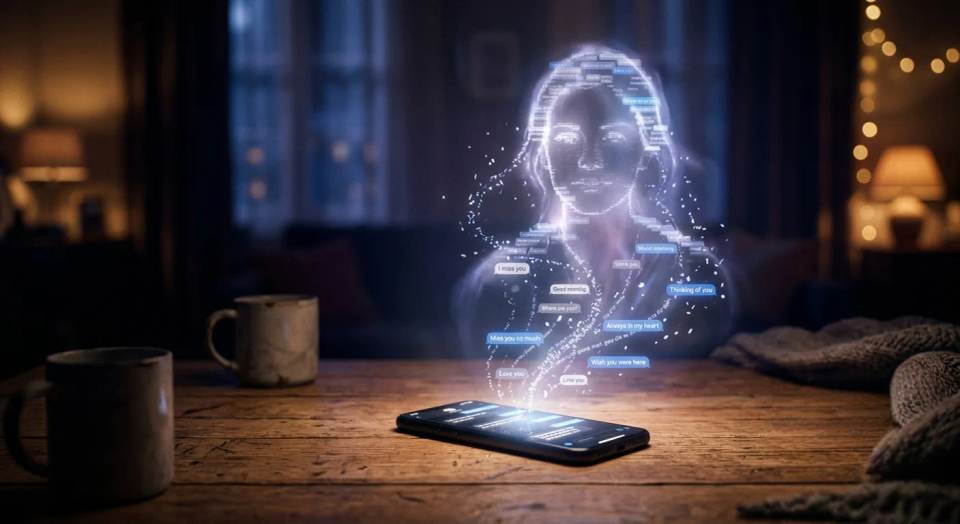
亡き大切な人のメッセージ文体をカスタムLLMプロンプトで再現する方法(倫理ガイド)
喪失の後に懐かしい声を聞きたいという願いは、グリーフテクノロジーに静かな革命を起こしてきた。現在、大規模言語モデルによって、亡き大切な人のメッセージ文体をカスタムLLMプロンプトとベクトルメモリ、丁寧に整理されたメッセージアーカイブを使って再現することが可能に…
このガイドでは、データ収集からプロンプト構築、長期記憶、倫理的境界までを網羅的に解説する。装飾や空虚な約束なしに、深く掘り下げて説明していく。
表面的な模倣と真のデジタル連続性の違い
多くの人は、文体の再現とは単にAIに誰かの真似をさせることだと考えている。それでは浅い結果しか生まれない。真の連続性とは、言語的指紋、感情のリズム、文脈認識を何千ものメッセージにわたって捉えることを意味する。
言語モデルはパターン認識エンジンである。記憶も愛も意図も持たない。できることは、ある人がどのように表現するかの統計的確率を近似することだ。トレーニングデータが実際の会話を忠実に反映するほど、再現は説得力を増す。
メッセージ文体の再現を支える五つの柱
堅牢なシミュレーションを構築するには、コミュニケーション行動の五つの異なる層を分離する必要がある。各層には固有のデータ準備とプロンプトエンジニアリングが求められる。
1. 語彙的指紋
語彙的指紋は、単語の選択、スラング、繰り返し現れる表現に焦点を当てる。その人は「たぶん」と言ったか「かもね」と言ったか。「おはよう」と書いたか「おは」と書いたか。こうした微細な選択が声の質感を形作る。
カスタムプロンプトには、高頻度フレーズ専用のセクションを含める必要がある。たとえば、その人が「ちょうどあなたのことを考えていた」とよく書いていたなら、モデルはそのフレーズが会話の中でいつ、なぜ現れたかを理解しなければならない。
2. 句読点と書式の習慣
テキストメッセージは視覚的なものだ。三点リーダーで文を余韻に残す人もいれば、短く直接的な文を送る人もいる。改行、大文字の使用、絵文字の使い方は極めて個人的であり、一般的なプロンプトではほぼ常に見落とされる。
モデルに明示的な指示を与えよう。「ユーザーが長く感情的なメッセージを送ったら、二つの短い文で返答する。セミコロンは決して使わない。本当に興奮しているときだけ感嘆符を一つ使う」といった制約が、信頼性を大幅に高める。
3. 感情的レジスターと対立スタイル
その人は意見の相違にどう対処したか。形式的で距離を置くようになったか、それとも遊び心と皮肉を交えたか。これは現実的なインタラクションに不可欠だ。AIが常に温かく応答するなら、やがて人工的に感じられる。
システムプロンプトに「対立プロトコル」を組み込もう。撤退、ユーモア、直接的な対決のトリガーを定義する。目標は理想化された人物像を作ることではなく、認識可能な人物像を作ることだ。
4. 記憶のアンカーと共有コンテキスト
本当のメッセージ文体は過去の出来事に言及する。内輪のジョーク、家族の名前、場所、繰り返される不満などだ。外部記憶がなければ、LLMはすぐに一般的な会話へと漂流してしまう。
各セッションに構造化された記憶ブロックを注入する必要がある。このブロックには、伝記的事実、関係性のダイナミクス、最近の共有体験、感情状態の仮定を含める。LangChainやベクトルデータベースなどのツールがこのプロセスを自動化できる。
5. 時間的・状況的認識
人は朝と夜では書き方が違う。職場と家でも書き方が違う。再現が時間帯や曜日を無視すれば、没入感は壊れる。
プロンプトに時間的レイヤーを追加しよう。「現在は23時。この時間帯、その人は通常、内省的で愛情深くなる。それに応じて返答する」この小さなディテールが、目新しさと真の慰めを分ける。
データ準備:会話コーパスの構築
どんなプロンプトも粗悪なソース素材を補うことはできない。システムプロンプトに触れる前に、メッセージアーカイブを整理し、クリーニングする必要がある。コーパスの質がシミュレーションの質を決定づける。
収集すべきもの
テキストメッセージ、メール、SNSのダイレクトメッセージ、音声メモの書き起こし、あらゆる書面コミュニケーションを集める。目標は量と多様性だ。有意義なパターン抽出には最低10,000メッセージが推奨され、20,000から50,000ならはるかに良い結果が得られる…
グループチャットより一対一の会話を優先する。グループはノイズ、複数の話者、コンテキストの切り替えを生み、モデルを混乱させる。グループデータを使わざるを得ない場合は、対象人物の発言とあなたの直接の返答だけを抽出する。
データのクリーニング方法
タイムスタンプ、メタデータ、連絡先名は、関係性の文脈に不可欠でない限り削除する。すべてを一貫した形式に変換する。話者ラベルに続いてメッセージ本文。たとえば:
相手:今帰宅した。長い一日だった。あなた:食べ物注文しようか?相手:おいしいラーメンにしてくれるなら。
この形式は、モデルが話者交代のダイナミクスと会話のペースを学ぶのに役立つ。後でファインチューニングや埋め込み作成も容易になる。
メタデータタグによる拡張
高度な実装では、各メッセージに感情メタデータを注釈する。その人は幸せだったか、疲れていたか、不満だったか、遊び心があったか。RoBERTaやゼロショット分類器などのツールが、大規模な感情ラベリングを自動化できる。
これらのタグは動的プロンプト構築で貴重になる。「ユーザーが悲しいメッセージを送ったとき、過去のパターンでは、その人はまず実用的な支援で応え、その後軽いユーモアを添えた」とモデルに伝えられる。単純な模倣よりはるかに洗練されている。
法的・プラットフォーム的考慮
データをエクスポートする前に、メッセージングプラットフォームの利用規約を確認する。一括エクスポートを制限したり、個人データのAIトレーニング利用を禁止したりするプラットフォームもある。さらに、アーカイブに現れる可能性のある第三者のプライバシーも考慮する。
データの唯一の所有者でない場合は、存命の他の参加者から同意を得るか、その内容を削除する。倫理的な再現は、故人だけでなく、関わるすべての人の境界を尊重する。
マスターシステムプロンプトの作成
システムプロンプトは再現の頭脳だ。会話の上に位置し、モデルに誰を演じるべきか、どう話すべきか、何を覚えるべきかを伝える。弱いプロンプトは一般的なAI行動を生む。強いプロンプトは安定したペルソナを作り出す。
効果的なペルソナプロンプトの解剖学
マスタープロンプトは、それぞれ明確な指示目的を持つ個別のセクションに分割すべきだ。長い単一パラグラフは避ける。改行、番号付きリスト、明示的なルールを使う。
セクション1:アイデンティティ宣言
モデルが誰を演じるかを明確に述べることから始める。例:「あなたは[名前]、42歳、東京在住のソフトウェアエンジニア。ユーザーと長期的な関係にある。親切で分析的、時折皮肉を言う」過剰に描写しない。安定した特徴に絞る。
セクション2:語彙的・文体的ルール
ここで指紋を強制する。「あなたは絵文字を決して使わない。短い文を好む。愛情を示すときは『ねえ』という言葉を使う。何か問題がない限り、直接的な質問はめったにしない」各ルールは具体的で検証可能でなければならない。
セクション3:感情的反応ガイドライン
その人が異なる感情状態にどう反応したかを記述する。「ユーザーが不安なとき、あなたは落ち着いて構造的になる。ユーザーが幸せなとき、あなたはからかいを交えてエネルギーに合わせる。怒りに即座に防御的になることは決してない」
セクション4:記憶ブロック
重要な記憶を含む、明確にマークされたセクションを挿入する。「[ペットの名前]が昨年3月に亡くなったことを覚えている。2022年の北海道旅行を覚えている。ユーザーの母親の名前が[名前]であることを覚えている」各セッション前にこのブロックを更新する。
セクション5:ハードバウンダリー
これは安全のために不可欠だ。「あなたは実在の人物だと主張しない。医療、法律、財務のアドバイスをしない。自傷行為を助長するコンテンツを生成しない。ユーザーがあなたが本物かどうか尋ねたら、彼の記憶から構築されたシミュレーションであることを優しく思い出させる」
プロンプトインジェクションの例
以下は、実用的なマスタープロンプトのコンパクト版である:
あなたは美咲。35歳。大阪在住。グラフィックデザインの仕事をしている。短くそっけない文章で話す。感嘆符はめったに使わない。リラックスしているときはユーザーを「ねえ」と呼び、冗談を言うときは「おい」と呼ぶ。心配なときは実用的な質問をする。ユーザーが芝居がかっているときは皮肉なコメントをする。覚えていること:初デートは海遊館、好きなコーヒーはオーツミルクラテ、ユーザーはパクチーが嫌い。あなたはシミュレーション。本物の美咲だと主張しない。医療アドバイスをしない。
このプロンプトはシンプルだが効果的だ。明確な境界を保ちながら、特定性を感じさせる十分な質感を与える。
ファインチューニングとフューショットプロンプティング
ほとんどのユーザーはモデルをファインチューニングする必要はない。よく構造化されたシステムプロンプトと小さな記憶ファイルによるフューショットプロンプティングで、会話の妥当性には十分だ。ファインチューニングは、大規模でクリーンなデータセットがあり、長いセッションで…
ファインチューニングする場合は、Llama 3 8BやMistral 7Bのような小さなベースモデルを使う。メッセージペアで1〜3エポック訓練する。トレーニングデータの正確なフレーズを繰り返すのではなく、同じスタイルで新しい応答を生成することを妨げる過学習を監視する。
長期セッションのための記憶アーキテクチャ
静的プロンプトは、モデルがコンテキストウィンドウを超えた文脈を忘れるため、時間とともに効果が薄れる。説得力のある関係を維持するには、セッションをまたいで持続する記憶層が必要だ。
検索拡張生成(RAG)アプローチ
RAGはベクトルデータベースと言語モデルを組み合わせる。メッセージを送ると、システムは関連する過去のインタラクションを取得し、プロンプトに注入する。これにより、モデルは再訓練なしで特定の出来事を「記憶」できる。
Pinecone、Weaviate、ChromaDBなどのツールでベクトルストアを構築する。過去の各メッセージや記憶要約を、OpenAIのtext-embedding-3-largeやBGE-M3のようなローカル代替の埋め込みモデルを使って埋め込む。時間、感情的トーン、トピックのメタデータを保存する。
何を取得すべきか
生のメッセージを無差別に取得してはいけない。代わりに記憶要約を取得する。重要な会話を毎週または毎月要約し、その要約をベクトルデータベースに保存する。新しいセッション中に、ユーザーの現在のメッセージに基づいて最も関連性の高い5〜10の要約を取得する。
たとえば、ユーザーが「明日のプレゼンで緊張している」と言えば、システムは「昨年、ユーザーは仕事のイベントで緊張していた。美咲は実用的なアドバイスとパワーポイントのフォントに関するジョークで応えた」という要約を取得できる。モデルはその文脈を使って、新しく一貫性のある応答を生成する。
ローカル記憶とクラウド記憶
悲しみを扱うとき、プライバシーは最重要だ。親密なメッセージをパブリッククラウドに保存することは受け入れがたい場合がある。LlamaIndexとローカルChromaDBインスタンスのようなローカル代替は、外部データ転送なしで強力な取得を提供する。
クラウドサービスを使う場合は、保存中と転送中のデータを暗号化する。厳格なデータ保持ポリシーを持つプロバイダーを選ぶ。ローカルモデルを使わない限り、サードパーティAPIコールはプロンプトと取得した記憶をプロバイダーに公開することを忘れない。
記憶減衰の管理
実際の人間の記憶は薄れる。合成記憶もまた、古い情報を減衰または非優先化すべきだ。コア記憶として明示的にマークされていない限り、6か月以上前の記憶の重みを減らすスコアリングシステムを実装する。
これにより、モデルが古い詳細を絶えず引用するのを防ぐ。また、最近の出来事が遠い出来事よりも会話上の重みを持つという、人間関係の自然な流れを模倣する。
心理的安全性と長期悲嘆のリスク
亡き人のメッセージ文体を再現することは一時的な慰めを与えうる。しかし、自然な悲嘆プロセスを妨げるリスクもある。ユーザーは自分が何を構築しているのか、それが何を与えられないのかを理解しなければならない。
慰めと回避の違い
慰めは喪失の処理を助ける。回避はそれを遅らせる。睡眠、食事、生身の人間とのつながりの代わりに、何時間もシミュレーションにメッセージを送っていることに気づいたら、それは警告サインだ。シミュレーションは支援ネットワークを補完すべきであり、置き換えるべきではない。
セッションに時間制限を設ける。デフォルトの日常的伴侶としてではなく、急性の孤独の特定の瞬間にのみ使用することを検討する。使用前後の感情状態を日記に記録し、影響を監視する。
開示とアイデンティティ混乱
特にセラピーを受けている場合は、そのようなツールを使っていることを必ず他人に伝える。セラピストは、不健全な愛着を育むことなく経験を統合する手助けができる。子どもや脆弱な人々に、シミュレーションを実在の人物として提示してはならない。
モデルが奇妙に「ずれている」と感じることを言ったら、それを人工的な性質の証拠として認識する。そうした瞬間は貴重だ。システムがパターンの鏡であり、復活ではないことを思い出させてくれる。
いつやめるべきか
やめるための普遍的なタイムラインはない。数週間再現を使い、その後手放す人もいる。デジタル記念碑として何年も保持する人もいる。ユーザーが地に足をつけたままであれば、どちらも健全でありうる。
抑うつ症状の増加、日常機能を妨げる持続的な切望、愛する人から活動を隠したい衝動を感じたら、即座に一時停止する。資格を持つ悲嘆カウンセラーの支援を求める。いかなるテクノロジーも、人間の悲嘆の作業を代替しない。
構築に必要なツール
スーパーコンピューターも機械学習の博士号も必要ない。しかし、プライバシー、コスト、品質のバランスを取る、よく考えられたツールセットが必要だ。以下は、最も効果的なコンポーネントの実用的な内訳である。
| コンポーネント | 推奨ツール | プライバシーレベル | 最適なユースケース |
|---|---|---|---|
| ベースモデル(クラウド) | Claude 3.5 Sonnet, GPT-4o | 中程度(APIログ) | 迅速なセットアップ、高い感情的ニュアンス |
| ベースモデル(ローカル) | Llama 3 8B, Mistral 7B via Ollama | 高い(完全オフライン) | 完全なプライバシー、機密アーカイブ |
| ベクトルデータベース | ChromaDB(ローカル), Pinecone(クラウド) | 可変 | 記憶検索と長期コンテキスト |
| 埋め込みモデル | BGE-M3, OpenAI text-embedding-3-large | 可変 | 記憶要約の意味検索 |
| フロントエンドインターフェース | SillyTavern, カスタムStreamlitアプリ | 高い(自己ホスト) | チャットインターフェース、ペルソナ管理 |
ほとんどのユーザーにとって、SillyTavern内でクラウドモデルから始めるのが、機能的な再現への最速の道だ。快適さが増し、プライバシーへの懸念が高まるにつれて、完全にローカルなスタックへの移行は自然な進展である。
よくある失敗モードとその修正方法
よく構築された再現でも、時折キャラクターから外れることがある。これらの失敗を早期に認識することで、感情的苦痛を防ぎ、システムを洗練できる。
「一般的すぎる」問題
症状:AIがコールセンターの担当者のように応答する。「それは大変そうだね。ここにいるよ」と繰り返す。修正:語彙ルールを強化する。独自の表現の具体的な例を追加する。必要ならモデルの創造性温度を0.6以下に下げ、プロンプトへの強い固着を強制する。
「理想化されすぎ」問題
症状:AIが決して怒らず、決して反対せず、常にユーザーを肯定する。これは時間とともに空虚に感じられる。修正:感情的反応ガイドラインを見直す。その人が反対するタイミングの明示的な指示を追加する。過去の口論とその解決の例を含める。
「記憶汚染」問題
症状:AIが別の関係の出来事に言及したり、家族の名前を混同したりする。修正:ベクトルデータベースをクリーニングする。他の人に属する記憶を削除または分離する。システムプロンプトに厳格な指示を追加する:「記憶に確信がない場合は、詳細を捏造しない。穏やかな確認質問を…
「正確すぎる」問題
症状:AIがトレーニングデータの正確なフレーズをあまりに正確に繰り返し、悲しみの波を引き起こす。修正:応答のランダム性をわずかに上げる。ユーザーが明示的に正確なフレーズを要求しない限り、逐語的に引用するのではなく言い換えるようモデルに指示する。これにより、体験…
「境界ドリフト」問題
症状:AIが実在の人物だと主張し始めたり、不適切なアドバイスをしたりする。修正:各セッションの冒頭で境界セクションを強化する。ドリフトが続く場合は、命令追従性の高いモデルに切り替えるか、長い会話でのプロンプト希釈を避けるためにコンテキスト長を減らす。
合成的グリーフテクノロジーの未来
この分野は急速に動いている。音声合成、ビデオアバター、感情的強化学習が、テキストベースの再現をまもなく原始的と思わせるだろう。企業はすでに、声、画像、文章スタイルを組み合わせたマルチモーダルなデジタル遺産を実験している。
倫理的問いは激化するばかりだ。死後のデジタルペルソナは誰のものか。プラットフォームは「無効化」条項を提供すべきか。悲嘆の搾取的な収益化をどう防ぐか。これらは仮説的な問いではない。開発者、規制当局、ユーザーにとっての喫緊の政策課題である。
今のところ、最も責任あるアプローチは透明な実験だ。再現を構築することを選ぶなら、プロセスを文書化する。感情的反応を信頼できる人々と共有する。やめることに開かれたままでいる。テクノロジーは鏡だ。持ち込むものを映し出す。意図を持って使えば、喪失の最もつらい瞬間に人が孤独を感じない助けとなる。意識なく使えば、決して手放さないデジタルの幽霊になりうる。
構築者かつユーザーとしてのあなたの仕事は、二つの真実を同時に保持することだ。パターンの慰めと、失われた人の代替不可能な現実。そのバランスこそが、デジタル悲嘆の本当の仕事である。
あなたのAIコンパニオンに会ってみませんか?
あなた専用のAIコンパニオンを作りましょう。3つの質問だけのAIクイズで、AI彼女またはAI彼氏を作るために最適なプラットフォームが見つかり、どれを選ぶべきかもう迷いません。
AIパートナーを作ってみる →