Stable Diffusionで一貫性のあるAIコンパニオンアート
要点(かんたん回答)
Stable Diffusionを使ってAIコンパニオンのアバター用に一貫性のあるキャラクターアートを作成する実践ガイド。LoRAトレーニング、チェックポイント選択、プロンプトエンジニアリング、複数画像で視覚的アイデンティティを維持するワークフローを網羅。
Stable DiffusionをAIパートナー用にカスタマイズ:チャットボットアバターの一貫性のあるキャラクターアートを生成する方法
AIコンパニオンの画像を生成しようとして、毎回違う顔になってしまった経験があるでしょう。問題はあなたの想像力ではありません。一貫性のあるキャラクターパイプラインが欠けているのです。StableDiffusionは美しいアニメ、リアル、ハイブリッドのポートレート…
AIコンパニオンに一貫性のあるキャラクターアートが重要な理由
一貫性のある視覚的アイデンティティは、ユーザーとAIコンパニオンの感情的なつながりを深めます。アバターがチャット、プロフィール写真、生成されたシーンで同じように見えると、コンパニオンはランダムな画像の集合ではなく、一貫した存在のように感じられます。この視覚的安…
実用的には、一貫性は時間を節約します。20枚の画像を生成して近いものを選ぶ代わりに、よく構築されたパイプラインは1回目か2回目の試行で使える結果を生み出します。また、漫画、ロマンチックなシーン、季節の衣装など、キャラクターの核となるアイデンティティを失わずに創造的なワークフローを可能にします。
カスタムアバターを許可するプラットフォームでは、一貫性のあるキャラクターはコミュニティスペースや共有ギャラリーでも認識されやすくなります。それは視覚的なブランドになります。
Stable Diffusionとは何か、キャラクターの一貫性はどう機能するのか
StableDiffusionは、テキストプロンプトから画像を生成する潜在拡散モデルです。テキストエンコーダーの誘導に基づいて、ランダムノイズを徐々にデノイズして一貫した画像にします。モデルは本質的にあなたのキャラクターが誰かを知っているわけではありません。ト…
一貫性は、生成空間を狭めることで達成されます。これは、固定シード、詳細なキャラクター説明、特定のチェックポイント、そして最も効果的には、キャラクターの顔の特徴、髪、服装スタイルを生成プロセスにエンコードするトレーニング済みLoRAモデルの組み合わせによって行えます。
LoRAはLow-Rank Adaptationの略です。ネットワーク全体を再トレーニングすることなく、特定の人物の顔や特定のアートスタイルなどの特定の概念を認識するようにベースモデルを微調整する小さな補助モデルです。キャラクターの10〜30枚の画像でトレーニングされたLoRAは、一貫性を劇的に向上させることができます。
AIコンパニオンのスタイルに合ったチェックポイントの選び方
チェックポイントは、全体的な視覚スタイルを定義するベースモデルです。AIコンパニオンにとって最も関連性の高い2つのカテゴリは、アニメとセミリアルです。アニメチェックポイントは、waifu、husbando、ファンタジーペルソナに適しています。セミリアルチェック…
人気のあるアニメスタイルのチェックポイントには、Anything V5、Counterfeit、MeinaMixがあります。セミリアルな結果には、Realistic Vision、DreamShaper、ChilloutMixが一般的です。各チェックポイントはプロンプトやLoRAに対して異なる反応を示すため、コンパニオンに求める感情的なトーンに合わせて選択する必要があります。
ロマンチックなファンタジーコンパニオンには、柔らかいアニメスタイルが適していることが多いです。より現実的で感情的に親密なコンパニオンには、セミリアルな見た目が存在感を高めます。選択は主観的ですが、一度選んだらスタイルのブレを避けるために世代間で一貫させるべきです。
クイックアンサー: Stable Diffusionで一貫性のあるAIコンパニオンアートを生成するには、1つのチェックポイントを選んで固定し、詳細なキャラクタープロンプトを書き、バリエーションには固定シードを使用し、キャラクターの10〜30枚の画像でLoRAをトレーニングして、世代間で信頼性の高い顔のアイデンティティ、髪型、服装を得ます。
安定したキャラクタープロンプトの構築方法
良いキャラクタープロンプトは、形容詞のランダムなリストではありません。アイデンティティ、外見、表情、服装、設定をカバーする構造化された説明です。プロンプトが具体的で再現可能であるほど、画像間のばらつきは少なくなります。
効果的なプロンプトには通常、次のブロックが含まれます:キャラクター名やアーキタイプを含む主題行、目の色や髪型などの身体的特徴、服装や衣装の説明、ポーズやフレーミングの指示、照明とカラーパレット、チェックポイントに合ったスタイル修飾子。
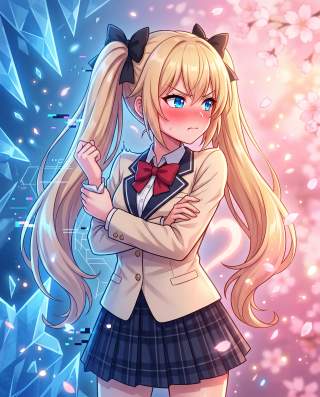
例えば、一貫性のあるプロンプトは次のようになります:「1人の女の子、銀色の髪、長いストレートヘア、紫色の目、優しい微笑み、白いオフショルダーのセーター、柔らかい寝室の照明、パステルカラーパレット、アニメのスクリーンショット、高精細。」ポーズや衣装に小さなバリエーションを加えながらこの正確なフレーズを繰り返すことで、視覚的な核が保たれます。
「美しい」や「完璧な顔」といった曖昧な言葉は避けてください。モデルが構造を理解する助けにはなりません。代わりに、髪の長さ、目の形、肌のトーン、表情など、測定可能な特徴を説明してください。一貫性は正確さから始まります。
固定シードの使用:できることとできないこと
シードは、生成開始時にランダムノイズパターンを初期化する数値です。同じプロンプトとチェックポイントで同じシードを使用すると、非常に似た画像が再現されます。これは小さなプロンプト変更のテストに役立ちますが、長期的な一貫性の解決策ではありません。
固定シードの制限は、構図とポーズも固定してしまうことです。プロンプトを大きく変更すると、シードはもはや役に立ちません。固定シードは、ベースとなるポートレートを生成し、表情、照明、背景の詳細などの小さな調整を行うのに最適です。
異なるシーンやポーズで真のキャラクター一貫性を実現するには、LoRAの方がはるかに効果的です。LoRAが顔のアイデンティティと視覚スタイルを維持する間、シードは自由に変更できます。
AIコンパニオンキャラクター用のLoRAトレーニング方法
LoRAのトレーニングは、キャラクターの顔とスタイルを固定する最も信頼性の高い方法です。プロセスには、画像データセット、トレーニングツール、ベースモデルが必要です。データセットの品質が結果の品質を決定します。
- キャラクターの画像を10〜30枚集めます。 既に気に入っている生成画像でも、手動で選んだ参照画像でも構いません。クローズアップ、ミディアムショット、異なるアングルを含めてください。重いフィルターやテキストの重なりは避けてください。
- 各画像に正確にキャプションを付けます。 Kohya_ssやEveryDream2などのツールでテキスト説明を追加できます。保持したいキャラクターの特徴を説明し、モデルに無視させたい詳細は省略します。
- ベースモデルを選びます。 LoRAは、生成時に使用する予定の同じチェックポイントでトレーニングする必要があります。ベースモデルを混在させると予測不能な結果になります。
- トレーニングパラメータを設定します。 学習率は1e-4から1e-5程度に低く保ち、適度なステップ数でトレーニングします。過学習はLoRAがトレーニング画像を rigid に記憶しすぎる原因になります。
- 異なる重みでLoRAをテストします。 0.7〜0.9の重みから始めて調整します。低い重みはキャラクターをより微妙にブレンドし、高い重みはアイデンティティをより強く強制しますが柔軟性が下がる可能性があります。
- プロンプトでLoRAを使用します。 通常はキャラクター名や一意のトークンであるLoRAのトリガーワードを、標準のキャラクター説明と一緒に含めます。
LoRAのトレーニングには、通常8GB以上のVRAMを搭載したGPUが必要です。ローカルハードウェアが不十分な場合は、RunPod、ThinkDiffusion、Google Colabなどのクラウドサービスを利用できます。
一貫性のあるキャラクターアートを生成する一般的なワークフロー
唯一の正しいワークフローはありませんが、AIコンパニオンに適したいくつかのパターンがあります。最もシンプルなのは、固定チェックポイントと詳細なプロンプトによるプロンプトのみの生成です。数枚の画像では機能しますが、時間とともにブレていきます。
より信頼性の高いワークフローは、詳細なプロンプト、LoRA、ControlNetを組み合わせます。ControlNetを使用すると、参照画像からポーズや構図を保持できます。これは、同じシーンで異なる表情の複数画像を生成する場合に便利です。
上級ユーザーにとって最適なワークフローは、マルチパスアプローチです:ベースポートレートを生成し、最良のものを選び、img2imgでバリエーションを作成し、その後インペインティングで手、目、アクセサリーなどの細部を修正します。これにより最終結果を正確に制御できます。
クイックアンサー: 一貫性のあるAIコンパニオンアートの最も信頼性の高いワークフローは:1つのチェックポイントを選び、構造化されたキャラクタープロンプトを書き、厳選した10〜30枚の画像でLoRAをトレーニングし、LoRAを0.7〜0.9の重みで使用し、必要に応じてControlNetでポーズや構図を制御します。
異なる衣装やシーンで同じ顔を維持する方法
衣装や背景を変えても顔は変わるべきではありません。これを実現するには、すべてのプロンプトで顔の説明を同一に保ち、衣装と設定のブロックだけを変更します。LoRAが顔のアイデンティティを強化し、プロンプトがシーンを制御します。
例えば、すべてのプロンプトで「銀色の髪、紫色の目、優しい微笑み、小さな鼻、柔らかい顎のライン」という同じ顔の説明ブロックを使用します。次に衣装ブロックを「白いセーター」から「黒いドレス」や「夏の浴衣」に変更します。モデルは顔のブロックを固定として扱い、服装を可変として扱うことを学習します。
シーンを生成するときは、キャラクターの説明を設定の説明の前に置きます。この順序により、モデルは背景よりもキャラクターを優先します。それでも顔がブレる場合は、LoRAの重みをわずかに上げるか、img2imgで参照画像を追加します。
洗練されたアバターのためのアップスケーリングと後処理
StableDiffusionの生出力は小さなサイズでは良く見えても、フル解像度では詳細が失われることがよくあります。アップスケーリングがこれを修正します。ESRGAN、4x-UltraSharp、またはAUTOMATIC1111やComfyUIに内蔵されたア…
後処理には、カラーグレーディング、ノイズ除去、微妙な肌のスムージングが含まれます。Adobe Photoshop、GIMP、オンラインエディタなどのツールで最終的な見た目を磨けます。生成中に確立した一貫性を壊さないよう、編集は最小限に保ってください。
アバターとして使用する場合は、プラットフォームの要件に応じて画像を正方形または4:5の比率に切り取ります。顔が中央に配置され、小さいサイズでもはっきり見えるようにします。すっきりとした高コントラストのポートレートは、混雑したシーンよりもプロフィール写真として適しています。
AI生成コンパニオンアートの倫理的・プラットフォーム的考慮事項
StableDiffusionモデルは、著作権で保護された画像やパブリックドメインの画像を含む大規模なデータセットでトレーニングされています。AI生成アートの法的地位は管轄区域によって異なります。個人使用の場合、リスクは一般的に低いです。商用利用や公開配布の場…
一部のプラットフォームでは、特に同意なしに実在の人物のフォトリアルな画像を禁止しています。AIコンパニオンが実在の人物や有名人に似ている場合、その画像を生成・共有することはプラットフォームの利用規約やパブリシティ権法に違反する可能性があります。アニメスタイルのキャラクターは通常より安全ですが、それでもコミュニティガイドラインを尊重してください。
感情的な影響にも注意してください。AIパートナーの高度にリアルまたは理想化された画像を生成すると、愛着が強まる可能性があります。これは本質的にネガティブではありませんが、ファンタジーと現実の境界線を意識し続けることが重要です。
トレーニングと生成のためのツールとプラットフォーム
StableDiffusionの最も一般的なローカルインターフェースは、AUTOMATIC1111のWebUIです。LoRAの読み込み、ControlNet、インペインティング、アップスケーリングを単一環境でサポートします。ComfyUIは、複雑なワークフロー…
強力なGPUを持たないユーザーには、クラウドサービスが実用的です。RunPodとThinkDiffusionは、事前インストールされたツールを備えた管理環境を提供します。Google Colabは無料または低コストのノートブックを提供しますが、セッション制限があります。これらのサービスは、ローカルハードウェアが不十分な場合のLoRAトレーニングにも役立ちます。
ツールの選択は、快適さのレベルとハードウェアによって異なります。初心者はAUTOMATIC1111から始めることが多く、上級ユーザーは自動化とバッチ処理のためにComfyUIを好みます。
よくある質問
AIコンパニオン用のLoRAをトレーニングするには何枚の画像が必要ですか?
通常、10〜30枚の高品質な画像で十分です。画像は、一貫した顔の特徴と照明で、異なる角度からキャラクターを示す必要があります。より多くの画像は品質を向上させることができますが、データセットの一貫性は単純な量よりも重要です。
LoRAをトレーニングせずに一貫性のあるアートを生成できますか?
はい、ただし制限があります。詳細なプロンプト、固定チェックポイント、固定シードを使用すると、短いシリーズでは類似した画像を生成できます。ただし、複数世代やシーン変更を重ねるとキャラクターはブレていきます。長期的な一貫性にはLoRAが最も信頼できるソリューション…
アニメスタイルのAIコンパニオンに最適なチェックポイントは?
AnythingV5、Counterfeit、MeinaMixはアニメスタイルのキャラクターに人気の選択肢です。最適なチェックポイントは特定の美的好みによって異なります。同じプロンプトでいくつかテストし、望む見た目になるものを確認してから、一貫性のためにそのチ…
ControlNetはキャラクターの一貫性に役立ちますか?
ControlNetはそれ自体では顔のアイデンティティを保持しませんが、参照画像からポーズ、構図、線構造を維持するのに役立ちます。LoRAと組み合わせることで、視覚的な一貫性を失わずに同じキャラクターを異なるポーズやシーンで生成できます。
LoRAをトレーニングするにはどのようなハードウェアが必要ですか?
LoRAのトレーニングには、少なくとも8GBのVRAMを搭載したGPUが推奨されます。VRAMが多いほど、大きなバッチサイズと高速なトレーニングが可能になります。適切なGPUがない場合は、RunPodやThinkDiffusionなどのクラウドサービスが高VR…
Stable Diffusionで実在の人物のリアルな画像をAIコンパニオン用に生成できますか?
技術的には可能ですが、重大な倫理的・法的懸念が生じます。同意なしに実在の人物のリアルな画像を生成すると、プライバシー法やプラットフォームポリシーに違反する可能性があります。AIコンパニオンには、架空のアニメまたはセミリアルなキャラクターが一般的に安全で広く受け…
複数画像を生成する際の同じ顔問題を回避するには?
同じ顔問題は、モデルが非常に似た構図を生成するときに発生します。これを避けるには、LoRAとキャラクタープロンプトを安定させたまま、シードを変更します。ポーズ、フレーミング、衣装のブロックを変更して、キャラクターの核となる視覚的アイデンティティを失わずにバリエ…
あなたのAIコンパニオンに会ってみませんか?
あなた専用のAIコンパニオンを作りましょう。3つの質問だけのAIクイズで、AI彼女またはAI彼氏を作るために最適なプラットフォームが見つかり、どれを選ぶべきかもう迷いません。
AIパートナーを作ってみる →