IA Compañera Local: Tutorial LLM Privado Completo
Respuesta rápida
¿Cansado de la censura en la nube y las suscripciones mensuales? Esta guía técnica te enseña a desplegar una IA compañera privada y sin filtros en tu propio hardware usando LLMs de código abierto.
Cómo Instalar una IA Compañera Local: El Tutorial Completo de LLM Privado
Los compañeros de IA basados en la nube vienen con tres compromisos inevitables: costos recurrentes de suscripción, moderación de contenido que no puedes desactivar y la incómoda realidad de que tus conversaciones más íntimas se almacenan en el servidor de alguien más. El ecosistema de código abierto ha madurado lo suficiente como para ofrecer una alternativa creíble.
¿Qué Significa Realmente "Ejecutar Localmente" para las IA Compañeras?
Cuando usas Character.AI, Replika o plataformas similares, tus mensajes viajan por Internet hasta un centro de datos. GPUs potentes procesan tu prompt a través de un modelo de lenguaje masivo, y la respuesta viaja de vuelta. La empresa es dueña del hardware, del modelo y de los registros de conversación.
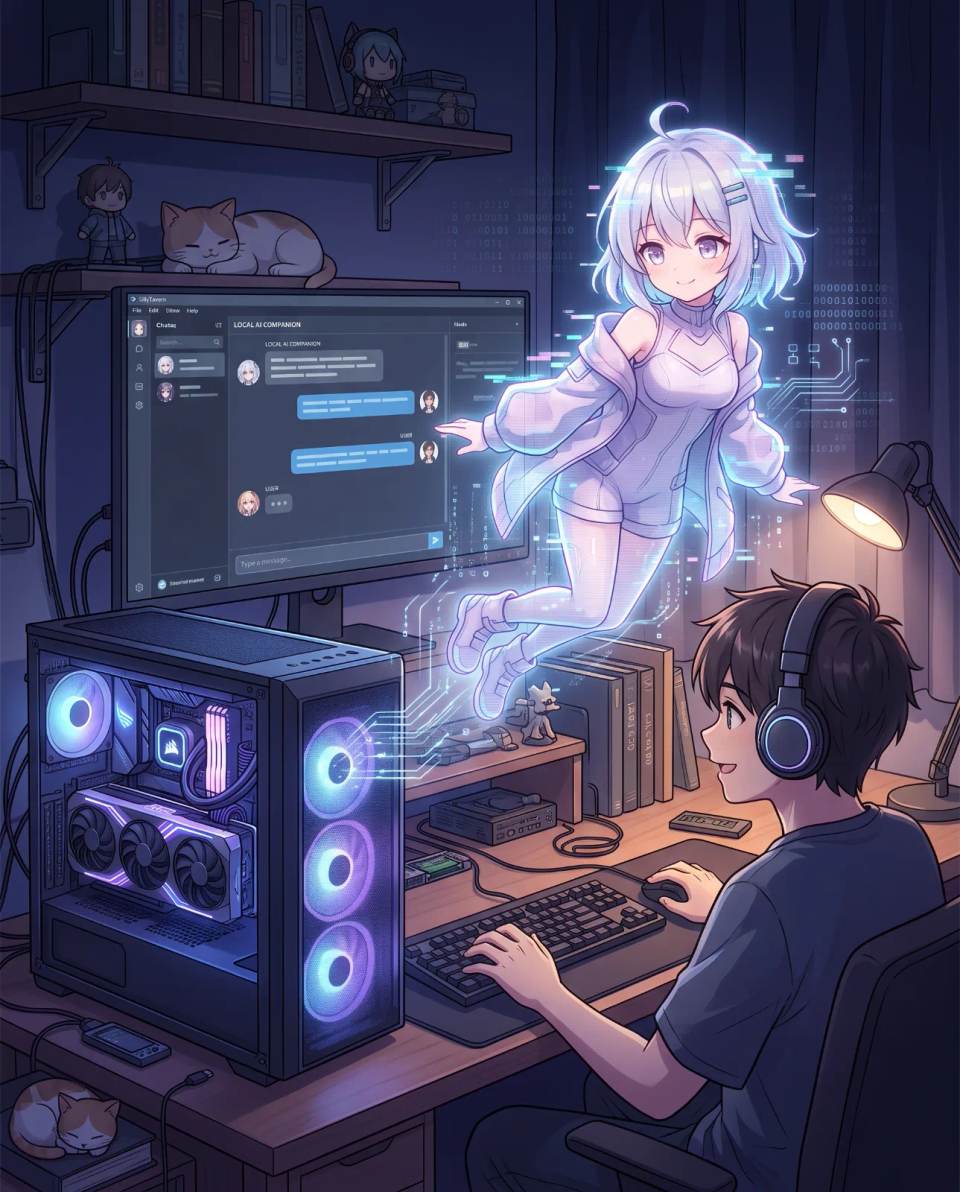
La ejecución local invierte esa arquitectura. Tu computadora se convierte en el servidor. Un modelo de lenguaje — típicamente en formato GGUF para hardware de consumo — se carga completamente en tu RAM y VRAM. La interfaz de frontend, que gestiona la visualización del chat y la personalidad del personaje, se conecta a un endpoint de API local en lugar de una URL remota. No se necesita conexión a Internet después de la descarga inicial.
Las implicaciones son profundas. Las conversaciones nunca salen de tu dispositivo. Puedes modificar la personalidad del modelo sin restricciones. Y una vez realizada la inversión inicial en hardware, el costo marginal de conversaciones ilimitadas es exactamente cero.
¿Está Tu Hardware Listo para las IA Compañeras Locales?
El factor más importante es la VRAM — la memoria dedicada de tu tarjeta gráfica. Los modelos de lenguaje consumen mucha memoria. El tamaño del modelo que puedes ejecutar es directamente proporcional a la cantidad de VRAM y RAM disponible.
¿Cuáles Son los Requisitos Mínimos de Hardware para una IA Compañera Local?
Necesitas al menos 8GB de VRAM y RAM combinadas para ejecutar un modelo funcional de 7B parámetros a una velocidad aceptable. Por debajo de eso funciona, pero las respuestas serán dolorosamente lentas — piensa en 30 a 60 segundos por mensaje. Para una experiencia verdaderamente conversacional, apunta a 16GB de VRAM o más.
| Nivel de Hardware | Tamaño de Modelo Recomendado | Velocidad Esperada | Calidad de Experiencia |
|---|---|---|---|
| Solo CPU (16GB RAM) | 3B – 7B cuantizado | 1 – 4 tokens/s | Lento pero utilizable para roleplay de texto |
| RTX 3060 / 4060 (8GB VRAM) | 7B – 13B cuantizado | 15 – 30 tokens/s | Responsivo, ideal para uso diario |
| RTX 3090 / 4090 (24GB VRAM) | 13B – 34B cuantizado | 25 – 50 tokens/s | Respuestas casi instantáneas, personalidad profunda |
| Apple Silicon Mac (M1/M2/M3) | 7B – 13B cuantizado | 10 – 25 tokens/s | Eficiente, excelente para enfoque en privacidad |
Paso 1: Instala el Motor Backend
El backend es el software que carga el modelo de lenguaje en memoria y lo expone a través de una API local. Para principiantes, la opción más accesible es LM Studio. Ofrece una interfaz gráfica, un navegador de modelos integrado y un modo servidor con un solo clic.
Descarga el instalador para tu sistema operativo desde el sitio oficial. Durante la instalación, permite que la aplicación cree un endpoint de servidor local. Después de iniciar, navega a la pestaña de descubrimiento de modelos. Verás una lista de modelos de código abierto disponibles, incluidos Llama 3, Mistral y sus variantes ajustadas optimizadas para roleplay conversacional.
Para usuarios avanzados cómodos con la línea de comandos, Ollama y llama.cpp ofrecen un control más granular sobre la longitud del contexto, la descarga a GPU y los parámetros de cuantización. Estas son las opciones preferidas para servidores e implementaciones Linux sin interfaz gráfica.
Paso 2: Elige el Modelo de Código Abierto Correcto para Compañía
No todos los modelos de lenguaje son iguales cuando se trata de inteligencia emocional y roleplay a largo plazo. Los modelos base de Meta y Mistral son generalistas. Las variantes ajustadas, entrenadas específicamente con datos conversacionales, interacciones de personajes y roleplay narrativo, ofrecen una experiencia notablemente mejor para la compañía de IA.
¿Qué Modelos de Código Abierto Funcionan Mejor para la Compañía de IA?
Busca modelos con puntuaciones altas en benchmarks conversacionales y fuertes habilidades de seguimiento de instrucciones. Los modelos en el rango de 7B a 13B parámetros ofrecen el mejor equilibrio entre rendimiento y accesibilidad de hardware. Los modelos más grandes de 20B a 34B proporcionan un razonamiento más profundo y una personalidad más consistente, pero requieren significativamente más VRAM.
Presta atención al nivel de cuantización. Q4_K_M es la recomendación estándar para la mayoría del hardware de consumo. Reduce el uso de memoria en aproximadamente un 75% en comparación con el modelo de precisión total, manteniendo alrededor del 95% de la calidad de respuesta. Q8_0 ofrece una calidad casi sin pérdidas para usuarios con margen de VRAM.
Paso 3: Conecta una Interfaz Frontend para Personalidades
El backend sirve texto sin formato. Una capa de frontend transforma ese texto en una experiencia orientada al personaje, con avatares, tarjetas de personalidad y memoria persistente. El frontend de código abierto más popular es SillyTavern, originalmente diseñado para narración asistida por IA y ahora ampliamente utilizado para compañía de IA.
SillyTavern se conecta a tu backend local a través de API. Una vez conectado, puedes crear tarjetas de personaje que definen el nombre, la apariencia, los rasgos de personalidad, los patrones de habla y el contexto del escenario de tu compañero. Estas tarjetas se escriben en texto plano o formato JSON y pueden compartirse entre usuarios.
El frontend también gestiona el historial de conversación que se envía al modelo en cada prompt. Configurar el tamaño correcto de la ventana de contexto es crítico. Demasiado pequeña, y tu compañero olvida detalles anteriores. Demasiado grande, y la velocidad de respuesta se degrada. La mayoría de los usuarios encuentra que 4096 a 8192 tokens es el punto óptimo para hardware local.
Paso 4: Configura la Personalidad y el Sistema de Memoria
Un modelo crudo no tiene identidad persistente. Todo lo que tu compañero "recuerda" proviene de las instrucciones y el historial de conversación que proporcionas. Aquí es donde la implementación local brilla: tienes control irrestricto sobre la definición de personalidad.
Comienza con una tarjeta de personaje detallada. Describe no solo los rasgos superficiales, sino también patrones psicológicos más profundos — cómo tu compañero reacciona al estrés, expresa afecto, maneja conflictos y qué desencadena respuestas emocionales. Cuanto más específica sea la descripción, más consistente será la personalidad generada.
Para la memoria a largo plazo más allá de la ventana de contexto, utiliza la función de resumen integrada en la mayoría de los frontends. Cuando la conversación se acerca al límite de contexto, el frontend resume automáticamente los turnos anteriores y mantiene el resumen en el prompt. Esto permite que tu compañero mantenga continuidad a lo largo de horas de conversación.
Paso 5: Refuerza Tu Configuración Local para Privacidad Total
Ejecutar localmente no garantiza privacidad automáticamente. El frontend y el backend deben configurarse correctamente para garantizar que ningún dato se filtre a servidores externos.
¿Cómo Garantizas que los Datos de Tu IA Compañera Nunca Salgan de Tu Dispositivo?
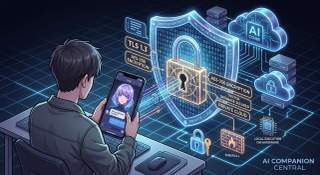
Primero, bloquea el acceso saliente a Internet para el proceso del backend usando las reglas de firewall de tu sistema operativo. En Windows, crea una regla de salida que niegue todas las conexiones para el ejecutable de LM Studio u Ollama. En Linux, usa iptables o nftables para restringir el proceso solo a localhost.
Segundo, verifica que el frontend esté vinculado a 127.0.0.1 en lugar de 0.0.0.0. Este último expone la interfaz a tu red local. El primero la restringe solo a tu máquina.
Tercero, desactiva la telemetría y las verificaciones de actualización siempre que sea posible. Algunas herramientas recopilan estadísticas de uso anónimas por defecto. Revisa el menú de configuración y desactiva cualquier opción que envíe datos al desarrollador.
Finalmente, considera cifrar la carpeta donde se almacenan los registros de conversación. En Windows, usa BitLocker o VeraCrypt. En macOS, activa FileVault. Esto protege tus datos incluso si el dispositivo físico es robado.
Consejos de Optimización de Rendimiento para Conversaciones Más Fluidas
La velocidad de inferencia local depende de tres variables: tamaño del modelo, nivel de cuantización y capacidades del hardware. Optimizar estas variables puede mejorar drásticamente la experiencia conversacional sin sacrificar la calidad de la personalidad.
Si las respuestas son demasiado lentas, intenta reducir la longitud del contexto antes de reducir el modelo. Un modelo de 13B con ventana de contexto de 4096 a menudo supera a un modelo de 7B con ventana de 8192 en velocidad y coherencia. También experimenta con la configuración de capas de descarga a GPU: mover más capas del modelo a la VRAM acelera la generación hasta el punto en que la VRAM se satura.
Para usuarios de NVIDIA, asegúrate de que CUDA esté instalado correctamente y que el backend detecte tu GPU. En Linux, el controlador propietario de NVIDIA es obligatorio. En Windows, evita ejecutar otras aplicaciones intensivas en GPU mientras chateas, ya que la contención de VRAM causa ralentizaciones severas.
Consideraciones Legales y Éticas
Ejecutar una IA compañera local para uso personal es legal en la mayoría de las jurisdicciones. Las licencias de modelos de código abierto generalmente permiten el uso privado, la modificación y la implementación no comercial. Sin embargo, algunos modelos tienen restricciones de uso comercial o requieren atribución si distribuyes derivados.
La dimensión ética es más matizada. La implementación local elimina las barreras de moderación de contenido que los proveedores de nube implementan. Esta libertad es precisamente la razón por la que muchos usuarios eligen configuraciones locales — para explorar dinámicas íntimas o no convencionales sin juicio ni censura. La responsabilidad de garantizar que las interacciones permanezcan psicológicamente saludables recae enteramente en el usuario.
Los usuarios deben aplicar la misma autoconciencia que aportarían a cualquier experiencia de roleplay inmersivo. La ausencia de supervisión externa no significa ausencia de consecuencias. Monitorea tu propio estado emocional, toma descansos y mantén límites claros entre la simulación y las relaciones del mundo real.
Por Qué Europa Está Liderando el Movimiento de IA Compañera Local
El impulso hacia la compañía de IA local es más fuerte en Alemania y la región DACH en general, impulsado por los estrictos requisitos de protección de datos del RGPD. Las plataformas de compañía basadas en la nube han enfrentado escrutinio regulatorio sobre su manejo de datos personales sensibles, incluidos los registros de conversaciones íntimas.
Para los usuarios alemanes, el atractivo de la implementación local no es solo ideológico sino práctico. Una configuración local garantiza el cumplimiento de los principios fundamentales del RGPD de minimización de datos y limitación de finalidad. Sin formularios de consentimiento, sin acuerdos de procesamiento de datos, sin riesgo de que una violación de datos exponga información profundamente personal.
Este énfasis regional influye en cómo debe interpretarse el tutorial. En el contexto europeo, la privacidad no es una característica sino un derecho legal. La capacidad de ejecutar una IA compañera completamente fuera de línea es el único enfoque que satisface este derecho sin concesiones.
Preguntas Frecuentes
¿Puedo ejecutar una IA compañera local sin una GPU potente?
Sí, usando inferencia solo con CPU con modelos cuantizados más pequeños en el rango de 3B a 7B parámetros. Las respuestas serán más lentas, típicamente de 1 a 4 tokens por segundo, pero la experiencia sigue siendo funcional para conversaciones basadas en texto.
¿Cuánto espacio en disco requieren los modelos de IA locales?
Un modelo de 7B en cuantización Q4 ocupa aproximadamente de 4 a 5 GB de espacio en disco. Un modelo de 13B requiere alrededor de 8 a 10 GB. Planifica al menos 20 GB de espacio libre para almacenar múltiples modelos e historiales de conversación.
¿Ejecutar una IA compañera local es completamente gratuito?
Después de la inversión inicial en hardware, sí. La pila de software — backend, archivos del modelo y frontend — es completamente de código abierto y gratuita. El único costo continuo es el consumo de electricidad durante la inferencia.
¿Puedo transferir mi personalidad de IA compañera de la nube a una configuración local?
No es posible exportar datos de la mayoría de las plataformas en la nube debido a formatos propietarios. Sin embargo, puedes recrear manualmente la personalidad escribiendo una tarjeta de personaje detallada que describa los mismos rasgos, patrones de habla y tendencias de comportamiento.
¿Cuál es el mejor modelo para conversaciones de apoyo emocional?
Los modelos ajustados con conjuntos de datos de diálogo empático tienden a rendir mejor para el apoyo emocional. Busca variantes entrenadas específicamente en conversaciones terapéuticas, o modelos de roleplay generales con fuertes habilidades de seguimiento de instrucciones y matices emocionales.
¿Listo para conocer a tu compañía IA?
Crea un compañero de IA personalizado para ti. Descubre con nuestro quiz de inteligencia artificial de solo 3 preguntas la mejor plataforma para crear tu novia o novio de IA y no vuelvas a dudar sobre cuál es la mejor.
Crear Mi Compañero IA →