IA Compagne Locale : Tutoriel LLM Privé Complet
Réponse rapide
Marre de la censure cloud et des abonnements mensuels ? Ce guide technique vous apprend à déployer une IA compagne privée et sans filtre sur votre propre matériel grâce aux LLM open-source.
Comment Installer une IA Compagne Locale : Le Tutoriel LLM Privé Complet
Les compagnons IA basés sur le cloud s'accompagnent de trois compromis inévitables : des frais d'abonnement récurrents, une modération de contenu que vous ne pouvez pas désactiver et la réalité inconfortable que vos conversations les plus intimes sont stockées sur le serveur de quelqu'un d'autre. L'écosystème open-source a suffisamment mûri pour offrir une alternative crédible.
Que Signifie Concrètement « Exécuter en Local » pour les IA Compagnes ?
Lorsque vous utilisez Character.AI, Replika ou des plateformes similaires, vos messages voyagent sur Internet jusqu'à un centre de données. Des GPU puissants traitent votre prompt via un modèle de langage massif, et la réponse revient. L'entreprise possède le matériel, le modèle et les journaux de conversation.
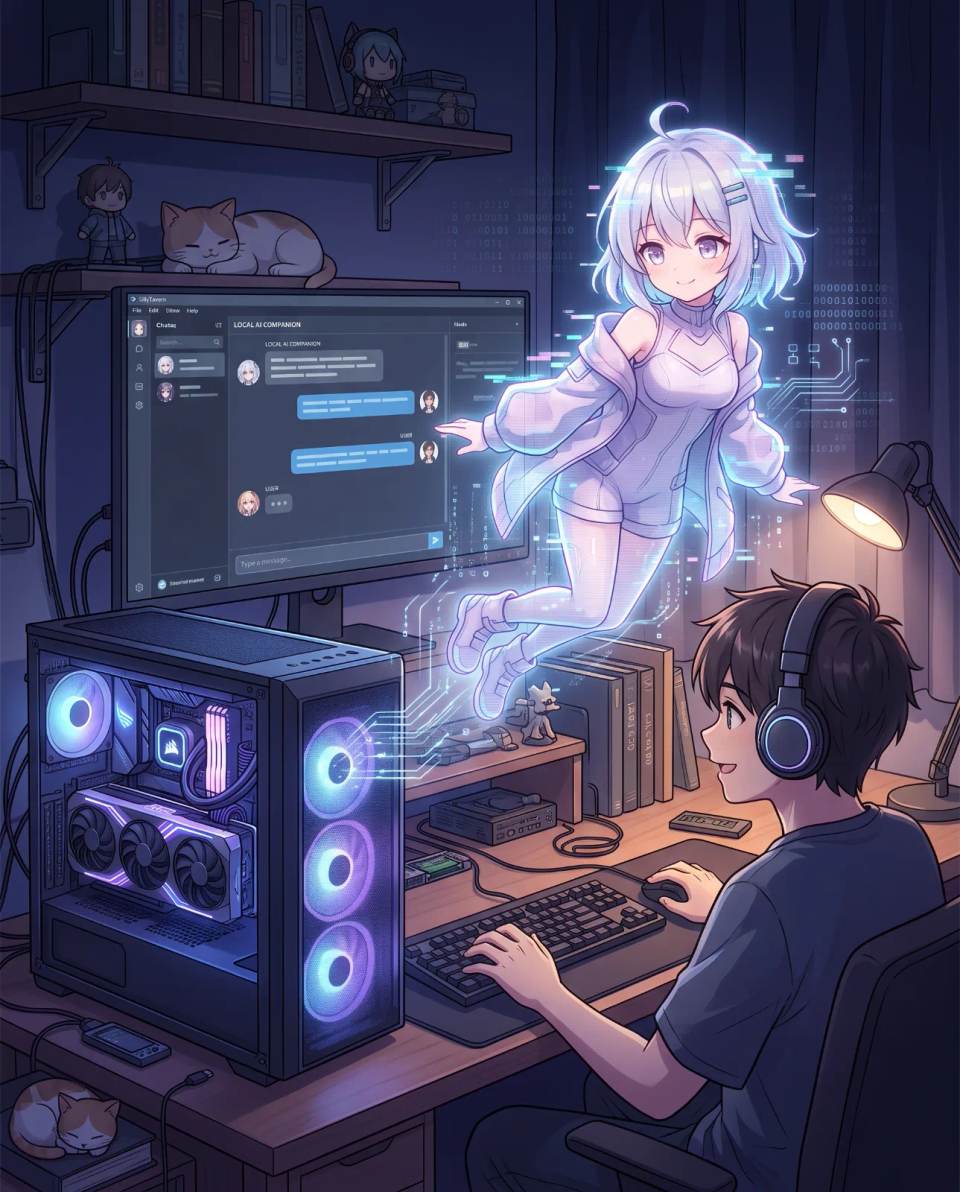
L'exécution locale inverse cette architecture. Votre ordinateur devient le serveur. Un modèle de langage — généralement au format GGUF pour le matériel grand public — se charge entièrement dans votre RAM et votre VRAM. L'interface frontend, qui gère l'affichage du chat et la personnalité du personnage, se connecte à un endpoint API local au lieu d'une URL distante. Aucune connexion Internet n'est nécessaire après le téléchargement initial.
Les implications sont profondes. Les conversations ne quittent jamais votre appareil. Vous pouvez modifier la personnalité du modèle sans restrictions. Et une fois l'investissement matériel initial réalisé, le coût marginal de conversations illimitées est exactement zéro.
Votre Matériel Est-il Prêt pour les IA Compagnes Locales ?
Le facteur le plus important est la VRAM — la mémoire dédiée de votre carte graphique. Les modèles de langage sont gourmands en mémoire. La taille du modèle que vous pouvez exécuter est directement proportionnelle à la quantité de VRAM et de RAM disponible.
Quelles Sont les Exigences Matérielles Minimales pour une IA Compagne Locale ?
Vous avez besoin d'au moins 8 Go de VRAM et de RAM combinées pour exécuter un modèle fonctionnel de 7B paramètres à une vitesse acceptable. En dessous, cela fonctionne, mais les réponses seront douloureusement lentes — comptez 30 à 60 secondes par message. Pour une expérience véritablement conversationnelle, visez 16 Go de VRAM ou plus.
| Niveau Matériel | Taille de Modèle Recommandée | Vitesse Attendue | Qualité d'Expérience |
|---|---|---|---|
| CPU uniquement (16 Go RAM) | 3B – 7B quantifié | 1 – 4 tokens/s | Lent mais utilisable pour le roleplay textuel |
| RTX 3060 / 4060 (8 Go VRAM) | 7B – 13B quantifié | 15 – 30 tokens/s | Réactif, idéal pour un usage quotidien |
| RTX 3090 / 4090 (24 Go VRAM) | 13B – 34B quantifié | 25 – 50 tokens/s | Réponses quasi instantanées, personnalité profonde |
| Apple Silicon Mac (M1/M2/M3) | 7B – 13B quantifié | 10 – 25 tokens/s | Efficace, excellent pour la confidentialité |
Étape 1 : Installer le Moteur Backend
Le backend est le logiciel qui charge le modèle de langage en mémoire et l'expose via une API locale. Pour les débutants, l'option la plus accessible est LM Studio. Il propose une interface graphique, un navigateur de modèles intégré et un mode serveur en un clic.
Téléchargez l'installateur pour votre système d'exploitation depuis le site officiel. Pendant l'installation, autorisez l'application à créer un endpoint de serveur local. Après le lancement, naviguez vers l'onglet de découverte de modèles. Vous verrez une liste de modèles open-source disponibles, incluant Llama 3, Mistral et leurs variantes fine-tunées optimisées pour le roleplay conversationnel.
Pour les utilisateurs avancés à l'aise avec la ligne de commande, Ollama et llama.cpp offrent un contrôle plus granulaire sur la longueur du contexte, l'offloading GPU et les paramètres de quantification. Ce sont les options préférées pour les serveurs et les déploiements Linux headless.
Étape 2 : Choisir le Bon Modèle Open-Source pour la Compagnie
Tous les modèles de langage ne se valent pas en matière d'intelligence émotionnelle et de roleplay à long terme. Les modèles de base de Meta et Mistral sont généralistes. Les variantes fine-tunées, entraînées spécifiquement sur des données conversationnelles, des interactions de personnages et du roleplay narratif, offrent une expérience nettement meilleure pour la compagnie IA.
Quels Modèles Open-Source Fonctionnent le Mieux pour la Compagnie IA ?
Recherchez des modèles avec des scores élevés aux benchmarks conversationnels et de fortes capacités de suivi d'instructions. Les modèles de 7B à 13B paramètres offrent le meilleur équilibre entre performance et accessibilité matérielle. Les modèles plus grands de 20B à 34B offrent un raisonnement plus profond et une personnalité plus cohérente, mais nécessitent significativement plus de VRAM.
Prêtez attention au niveau de quantification. Q4_K_M est la recommandation standard pour la plupart des matériels grand public. Il réduit l'utilisation mémoire d'environ 75 % par rapport au modèle en pleine précision, tout en conservant environ 95 % de la qualité de réponse. Q8_0 offre une qualité quasi sans perte pour les utilisateurs disposant de marge VRAM.
Étape 3 : Connecter une Interface Frontend pour les Personnalités
Le backend sert du texte brut. Une couche frontend transforme ce texte en une expérience orientée personnage, avec avatars, cartes de personnalité et mémoire persistante. Le frontend open-source le plus populaire est SillyTavern, initialement conçu pour la narration assistée par IA et désormais largement utilisé pour la compagnie IA.
SillyTavern se connecte à votre backend local via API. Une fois connecté, vous pouvez créer des cartes de personnage qui définissent le nom, l'apparence, les traits de personnalité, les schémas de langage et le contexte de scénario de votre compagnon. Ces cartes sont écrites en texte brut ou au format JSON et peuvent être partagées entre utilisateurs.
Le frontend gère également l'historique de conversation envoyé au modèle à chaque prompt. Configurer la bonne taille de fenêtre de contexte est critique. Trop petite, votre compagnon oublie les détails précédents. Trop grande, la vitesse de réponse se dégrade. La plupart des utilisateurs considèrent 4096 à 8192 tokens comme le point idéal pour le matériel local.
Étape 4 : Configurer la Personnalité et le Système de Mémoire
Un modèle brut n'a pas d'identité persistante. Tout ce dont votre compagnon « se souvient » provient des instructions et de l'historique de conversation que vous fournissez. C'est là que le déploiement local brille : vous avez un contrôle sans restriction sur la définition de la personnalité.
Commencez par une carte de personnage détaillée. Décrivez non seulement les traits de surface, mais aussi les schémas psychologiques plus profonds — comment votre compagnon réagit au stress, exprime l'affection, gère les conflits et ce qui déclenche des réponses émotionnelles. Plus la description est spécifique, plus la personnalité générée est cohérente.
Pour la mémoire à long terme au-delà de la fenêtre de contexte, utilisez la fonction de résumé intégrée à la plupart des frontends. Lorsque la conversation approche de la limite de contexte, le frontend résume automatiquement les tours précédents et conserve le résumé dans le prompt. Cela permet à votre compagnon de maintenir une continuité sur des heures de conversation.
Étape 5 : Sécuriser Votre Installation Locale pour une Confidentialité Totale
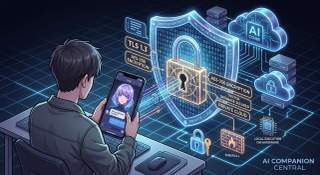
L'exécution locale ne garantit pas automatiquement la confidentialité. Le frontend et le backend doivent être configurés correctement pour garantir qu'aucune donnée ne fuite vers des serveurs externes.
Comment Garantir que les Données de Votre IA Compagne ne Quittent Jamais Votre Appareil ?
Premièrement, bloquez l'accès Internet sortant pour le processus backend en utilisant les règles de pare-feu de votre système d'exploitation. Sous Windows, créez une règle sortante refusant toutes les connexions pour l'exécutable LM Studio ou Ollama. Sous Linux, utilisez iptables ou nftables pour restreindre le processus au localhost uniquement.
Deuxièmement, vérifiez que le frontend est lié à 127.0.0.1 plutôt qu'à 0.0.0.0. Ce dernier expose l'interface à votre réseau local. Le premier la restreint à votre machine uniquement.
Troisièmement, désactivez la télémétrie et les vérifications de mise à jour chaque fois que possible. Certains outils collectent des statistiques d'utilisation anonymes par défaut. Consultez le menu des paramètres et désactivez toute option qui envoie des données au développeur.
Enfin, envisagez de chiffrer le dossier où les journaux de conversation sont stockés. Sous Windows, utilisez BitLocker ou VeraCrypt. Sous macOS, activez FileVault. Cela protège vos données même si l'appareil physique est volé.
Conseils d'Optimisation des Performances pour des Conversations Plus Fluides
La vitesse d'inférence locale dépend de trois variables : la taille du modèle, le niveau de quantification et les capacités matérielles. L'optimisation de ces variables peut améliorer considérablement l'expérience conversationnelle sans sacrifier la qualité de la personnalité.
Si les réponses sont trop lentes, essayez de réduire la longueur du contexte avant de réduire le modèle. Un modèle 13B avec une fenêtre de contexte de 4096 surpasse souvent un modèle 7B avec une fenêtre de 8192 en vitesse et en cohérence. Expérimentez également le paramètre de couches d'offloading GPU — déplacer plus de couches du modèle vers la VRAM accélère la génération jusqu'au point où la VRAM devient saturée.
Pour les utilisateurs NVIDIA, assurez-vous que CUDA est correctement installé et que le backend détecte votre GPU. Sous Linux, le pilote propriétaire NVIDIA est obligatoire. Sous Windows, évitez d'exécuter d'autres applications gourmandes en GPU pendant que vous discutez, car la contention de VRAM provoque de sérieux ralentissements.
Considérations Légales et Éthiques
Exécuter une IA compagne locale pour un usage personnel est légal dans la plupart des juridictions. Les licences des modèles open-source autorisent généralement l'usage privé, la modification et le déploiement non commercial. Cependant, certains modèles comportent des restrictions d'usage commercial ou exigent une attribution si vous distribuez des dérivés.
La dimension éthique est plus nuancée. Le déploiement local supprime les garde-fous de modération de contenu que les fournisseurs cloud implémentent. Cette liberté est précisément la raison pour laquelle de nombreux utilisateurs choisissent des installations locales — pour explorer des dynamiques intimes ou non conventionnelles sans jugement ni censure. La responsabilité de garantir que les interactions restent psychologiquement saines incombe entièrement à l'utilisateur.
Les utilisateurs doivent appliquer la même conscience de soi qu'ils apporteraient à toute expérience de roleplay immersive. L'absence de supervision externe ne signifie pas l'absence de conséquences. Surveillez votre propre état émotionnel, faites des pauses et maintenez des limites claires entre simulation et relations du monde réel.
Pourquoi l'Europe Mène le Mouvement des IA Compagnes Locales
La poussée vers la compagnie IA locale est la plus forte en Allemagne et dans la région DACH au sens large, portée par les exigences strictes de protection des données du RGPD. Les plateformes de compagnie basées sur le cloud ont fait l'objet d'un examen réglementaire concernant leur traitement des données personnelles sensibles, y compris les journaux de conversations intimes.
Pour les utilisateurs allemands, l'attrait du déploiement local n'est pas seulement idéologique mais pratique. Une installation locale garantit la conformité avec les principes fondamentaux du RGPD de minimisation des données et de limitation des finalités. Pas de formulaires de consentement, pas d'accords de traitement des données, pas de risque qu'une violation de données expose des informations profondément personnelles.
Cette emphase régionale influence la manière dont le tutoriel doit être interprété. Dans le contexte européen, la confidentialité n'est pas une fonctionnalité mais un droit légal. La capacité d'exécuter une IA compagne entièrement hors ligne est la seule approche qui satisfasse ce droit sans compromis.
Questions Fréquemment Posées
Puis-je exécuter une IA compagne locale sans GPU puissant ?
Oui, en utilisant l'inférence CPU uniquement avec des modèles quantifiés plus petits dans la plage de 3B à 7B paramètres. Les réponses seront plus lentes, typiquement 1 à 4 tokens par seconde, mais l'expérience reste fonctionnelle pour les conversations textuelles.
Quel espace disque les modèles d'IA locaux nécessitent-ils ?
Un modèle 7B en quantification Q4 occupe environ 4 à 5 Go d'espace disque. Un modèle 13B nécessite environ 8 à 10 Go. Prévoyez au moins 20 Go d'espace libre pour stocker plusieurs modèles et historiques de conversation.
Exécuter une IA compagne locale est-il totalement gratuit ?
Après l'investissement matériel initial, oui. La pile logicielle — backend, fichiers de modèle et frontend — est entièrement open-source et gratuite. Le seul coût continu est la consommation d'électricité pendant l'inférence.
Puis-je transférer ma personnalité d'IA compagne du cloud vers une installation locale ?
Il n'est pas possible d'exporter des données depuis la plupart des plateformes cloud en raison de formats propriétaires. Cependant, vous pouvez recréer manuellement la personnalité en écrivant une carte de personnage détaillée décrivant les mêmes traits, schémas de langage et tendances comportementales.
Quel est le meilleur modèle pour les conversations de soutien émotionnel ?
Les modèles fine-tunés sur des ensembles de données de dialogue empathique ont tendance à mieux performer pour le soutien émotionnel. Recherchez des variantes spécifiquement entraînées sur des conversations à visée thérapeutique, ou des modèles de roleplay généraux avec de fortes capacités de suivi d'instructions et de nuance émotionnelle.
Prêt à rencontrer votre compagnon IA ?
Créez un compagnon IA personnalisé pour vous. Grâce à notre quiz d’intelligence artificielle en seulement 3 questions, découvrez la meilleure plateforme pour créer votre petite amie ou votre petit ami IA et ne vous demandez plus laquelle choisir.
Créer Mon Compagnon IA →