Sind KI-Begleiter sicher? Datenschutz & DSGVO-Analyse
Kurze Antwort
Wie sicher sind Ihre privaten Chats mit KI-Begleitern? Wir analysieren Vektordatenbanken, Verschlüsselungsstandards und DSGVO-Risiken im Detail.
Die ungeschminkte Wahrheit über den Datenschutz von KI-Begleitern: Technische Architektur und Backend-Transparenz
Die zunehmende Integration von KI-Begleitern in den Alltag verändert die Art und Weise, wie Menschen auf emotionaler Ebene mit Technologie interagieren.
Diese digitalen Interaktionen sind nicht mehr auf einfache Suchanfragen beschränkt, sondern umfassen intime Geständnisse, psychologische Befindlichkeiten und persönliche Lebensroutinen.
Aus der Perspektive der Datensicherheit entsteht dadurch ein beispielloses Risiko: Die massive Zentralisierung hochsensibler Verhaltensdaten auf Servern von Drittanbietern.
Besonders im europäischen Raum, der durch die Datenschutz-Grundverordnung (DSGVO) streng reguliert ist, müssen Nutzer die technische Realität hinter diesen Anwendungen verstehen.
Es reicht nicht aus, sich auf vage Datenschutzerklärungen zu verlassen; wir müssen die Backend-Architektur, die Verschlüsselungsprotokolle und die Datenflüsse präzise analysieren.
Dieser Leitfaden dekonstruiert die Sicherheitsinfrastruktur moderner KI-Begleiter und offenbart, was mit Ihren sensibelsten Texteingaben tatsächlich geschieht.
Architektur des KI-Gedächtnisses: Wie und wo werden Ihre sensiblen Chats gespeichert?
Damit ein digitaler Begleiter den Kontext einer Konversation über Wochen hinweg aufrechterhalten kann, ist eine hochkomplexe Speicherinfrastruktur erforderlich.
Im Gegensatz zu traditionellen Messengern, die Text chronologisch in relationalen Datenbanken ablegen, nutzen moderne KI-Systeme sogenannte Vektordatenbanken wie Pinecone, Weaviate oder Qdrant.
Ihre Eingaben werden durch ein Embedding-Modell in hochdimensionale numerische Vektoren umgewandelt, die semantische und emotionale Bedeutung mathematisch repräsentieren.
Durch Retrieval-Augmented Generation (RAG) durchsucht das System diese Vektordatenbank bei jeder neuen Nachricht in Echtzeit, um relevante Erinnerungen in den Prompt zu injizieren.
Ihre privatesten Gedanken ruhen also nicht sicher in einem verschlüsselten Archiv, sondern sind permanent Teil einer hochaktiven, abfragebasierten Cloud-Infrastruktur.
Wenn diese Datenbanken nicht mit strikten Zugriffsrechten (IAM-Richtlinien) und Verschlüsselung auf Laufwerksebene gesichert sind, stellen sie ein massives Angriffsrisiko dar.
Lesen Entwickler meine privaten Konversationen mit der KI mit?
Rein technisch betrachtet haben die Systemadministratoren und Backend-Ingenieure der Betreiberfirma fast immer die Möglichkeit, auf unverschlüsselte Chatprotokolle zuzugreifen.
Obwohl es für Entwickler ineffizient und uninteressant ist, Millionen von Chats manuell zu lesen, erzwingen automatisierte Moderationssysteme (Trust and Safety) oft menschliche Eingriffe.
Wenn Ihre Texteingabe bestimmte Schlüsselwörter enthält, die auf illegale Aktivitäten, Selbstgefährdung oder Verstöße gegen die Nutzungsbedingungen hindeuten, wird ein Alarm ausgelöst.
In solchen Fällen erhalten menschliche Moderatoren oder Compliance-Teams vorübergehenden Lesezugriff auf den spezifischen Chatverlauf, um den Kontext zu auditieren.
Darüber hinaus erfordern technische Debugging-Prozesse bei Serverabstürzen oder LLM-Halluzinationen oft, dass Ingenieure die rohen Server-Logs analysieren.
Eine echte "Zero-Knowledge"-Architektur, bei der der Betreiber mathematisch von der Datenentschlüsselung ausgeschlossen ist, existiert bei cloudbasierten generativen KI-Modellen nicht.
Die Illusion der Ende-zu-Ende-Verschlüsselung bei cloudbasierten KI-Modellen
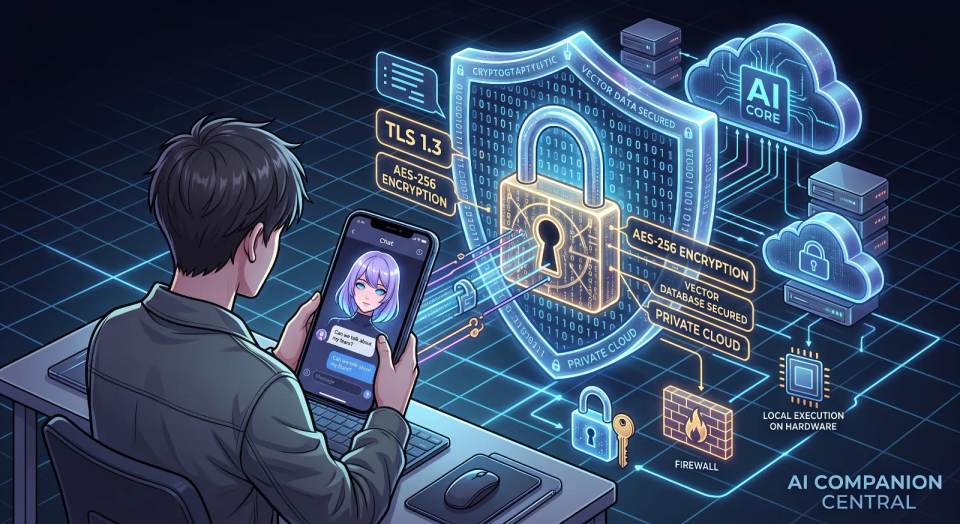
Verbraucher verwechseln häufig die Transportverschlüsselung (In-Transit) mit einer echten Ende-zu-Ende-Verschlüsselung (E2EE), wie sie bei Signal oder Threema Standard ist.
Seriöse KI-Anwendungen sichern die Verbindung zwischen Ihrem Endgerät und dem Cloud-Server durch Transport Layer Security (TLS 1.2 oder 1.3), was Man-in-the-Middle-Angriffe verhindert.
Sobald Ihr Datenpaket jedoch die Server-Infrastruktur des Anbieters erreicht, muss es zwingend entschlüsselt werden, damit der Prozessor (GPU/TPU) den Text verarbeiten kann.
Ein Large Language Model (LLM) kann keine kryptografisch verschlüsselten Zeichenfolgen verstehen; es benötigt den reinen Klartext, um Token zu generieren und logisch zu antworten.
Da der Server des Unternehmens aktiv Berechnungen auf Basis Ihres Textes durchführt, muss er zwingend im Besitz der Entschlüsselungsschlüssel sein.
Echtes E2EE ist somit bei cloudbasierten KI-Begleitern ein technisches Paradoxon und ein leeres Marketingversprechen, vor dem europäische Verbraucherschützer ausdrücklich warnen.
| Architektur-Typ | Verschlüsselungsstandard | Backend-Zugriff | Datenschutzniveau (DSGVO) |
|---|---|---|---|
| Drittanbieter-API (z.B. OpenAI) | TLS 1.3 (Transport), AES-256 (Ruhend) | Hoch (App-Entwickler + API-Provider) | Gering bis Mittel |
| Proprietäres Cloud-Modell | TLS 1.3 (Transport), AES-256 (Ruhend) | Moderat (Nur internes Team) | Mittel |
| Lokale Ausführung (Local LLM) | Entfällt (Absoluter Air-Gap) | Keiner | Maximal |
Werden meine intimsten Geheimnisse für das Training zukünftiger KI-Modelle verwendet?
Dies ist der kritischste Aspekt der Datenethik und hängt vollständig von den rechtlichen Rahmenbedingungen und der technischen Infrastruktur des jeweiligen Anbieters ab.
Zahlreiche "Freemium"-Applikationen monetarisieren ihre Nutzerbasis indirekt, indem sie Chatprotokolle für das Reinforcement Learning from Human Feedback (RLHF) nutzen.
Unter dem euphemistischen Begriff "Serviceverbesserung" werden Ihre Gespräche in gigantische Datensätze eingespeist, um die Antwortqualität kommender LLM-Generationen zu verfeinern.
In der Europäischen Union verlangt die DSGVO für solche Verarbeitungsschritte zwingend ein aktives Opt-in (ausdrückliche Einwilligung), das jedoch oft in langen AGBs versteckt wird.
Nutzt die Applikation eine kommerzielle "Enterprise-API" eines großen Anbieters (wie Anthropic oder OpenAI), schließen Verträge das Modell-Training durch den API-Provider oft aus.
Das schützt Sie jedoch nicht davor, dass der Entwickler der Benutzeroberfläche (die eigentliche App) Ihre Daten abfängt und für eigene, unregulierte Trainingszwecke speichert.
Versteckte Datenlecks: Die Gefahr durch Drittanbieter-SDKs und Metadaten-Tracking
Auch wenn das Kern-KI-Modell strenge Datenschutzrichtlinien aufweist, stellt die mobile Applikation selbst oft ein signifikantes Sicherheitsrisiko dar.
Entwickler integrieren routinemäßig Software Development Kits (SDKs) von Drittanbietern für Crash-Reporting, Nutzeranalytik und gezieltes Werbe-Tracking (z.B. Firebase, AppsFlyer).
Diese Tracker saugen im Hintergrund kontinuierlich Metadaten ab: Wann Sie die App öffnen, wie lange Ihre Sessions dauern und welche UI-Elemente Sie am häufigsten antippen.
Obwohl diese Tools den reinen Text Ihrer Konversation nicht lesen, generieren sie hochpräzise Verhaltensprofile, die auf soziale Isolation, Schlaflosigkeit oder emotionale Vulnerabilität schließen lassen.
Datenbroker können diese Metadaten mit Geräte-IDs verknüpfen und so ein umfassendes psychografisches Profil erstellen, das für extrem zielgerichtete Werbung genutzt wird.
Die Kombination aus intimer KI-Nutzung und aggressivem Metadaten-Tracking stellt einen gravierenden Eingriff in die digitale informationelle Selbstbestimmung dar.
Was passiert DSGVO-konform mit meinen Daten, wenn ich mein KI-Konto lösche?
Das Drücken des "Konto löschen"-Buttons führt in der Praxis selten zu einer sofortigen und unwiderruflichen Zerstörung Ihrer Datenfragmente auf den Servern.
Die meisten Systeme verwenden einen "Soft-Delete"-Mechanismus, bei dem der Datenbankeintrag lediglich ein Flag erhält, das ihn für die Benutzeroberfläche unsichtbar macht.
Ihre Vektordaten, Chat-Logs und Abrechnungsinformationen verbleiben aus Gründen der Fehlerbehebung oder für rechtliche Compliance oft für 30 bis 90 Tage in verschlüsselten Backups.
Als EU-Bürger haben Sie nach Artikel 17 DSGVO das "Recht auf Löschung" (Recht auf Vergessenwerden), das Unternehmen zur restlosen Beseitigung aller personenbezogenen Daten verpflichtet.
Um dieses Recht gegenüber internationalen Anbietern ohne europäischen Hauptsitz durchzusetzen, ist jedoch oft eine direkte formelle Kommunikation mit dem Datenschutzbeauftragten (DPO) erforderlich.
Ohne diese explizite juristische Aufforderung verlassen Sie sich blind auf die oft fehlerhaften automatisierten Bereinigungsprozesse der Betreiber.
Die API-Lieferkette: Wer verarbeitet Ihre Prompts im Backend wirklich?
Die überwältigende Mehrheit der KI-Begleiter im App Store verfügt nicht über das Kapital oder die Hardware, um eigene Foundation-Modelle von Grund auf zu trainieren und zu hosten.
Sie fungieren lediglich als grafische "Wrapper" – Schnittstellen, die Ihre Nachrichten entgegennehmen und via API an die Server von Tech-Giganten weiterleiten.
Dadurch entsteht eine undurchsichtige Daten-Lieferkette: Ihr intimster Text verlässt die Server der App-Firma und wird von einer völlig anderen Unternehmenseinheit verarbeitet.
Jeder zusätzliche Knotenpunkt in diesem Netzwerk erhöht das Risiko von Datenlecks, Server-Fehlkonfigurationen oder stillschweigenden Änderungen der Datenschutzrichtlinien.
Selbst wenn die App verspricht, Ihre Daten niemals zu speichern, behält der API-Provider oft Server-Logs für 30 Tage ein, um Missbrauch und illegale Aktivitäten zu überwachen.
Eine tiefgehende technische Due-Diligence erfordert daher, die Datenschutzvereinbarungen sowohl des Frontend-Wrappers als auch des zugrundeliegenden LLM-Providers zu prüfen.
Bieten lokale Open-Source-LLMs die einzige absolute Garantie für Datenschutz?
Für Nutzer, die keinerlei Kompromisse bei der Vertraulichkeit ihrer Gedanken eingehen möchten, existiert nur eine einzige logische Lösung: Die lokale Ausführung auf eigener Hardware.
Durch Open-Source-Ökosysteme wie LM Studio, Ollama oder text-generation-webui können unzensierte Sprachmodelle direkt auf dem privaten Desktop-PC gehostet werden.
Da die gesamte Inferenz (Texterstellung) ausschließlich durch die lokale CPU und GPU berechnet wird, verlässt nicht ein einziges Datenpaket Ihren Router.
Dieser physische Air-Gap (Netzwerktrennung) eliminiert Tracking, API-Überwachung und die Gefahr von Cloud-Hacks vollständig – Sie besitzen die absolute Datenhoheit.
Dieses Privileg der ultimativen Privatsphäre erfordert jedoch erhebliches technisches Know-how und signifikante Investitionen in High-End-Hardware, insbesondere Grafikkarten mit großem VRAM.
Bis effizientere Edge-Computing-Lösungen für Mobilgeräte verfügbar sind, bleibt absolute digitale Souveränität ein Privileg für technikaffine Enthusiasten.
Anonymisierung und Datenbereinigung: Ein gefährlicher technischer Mythos?
Cloud-Betreiber verteidigen ihre massenhafte Datenerfassung häufig mit der Behauptung, alle Eingaben würden vor der Speicherung oder dem Training strikt anonymisiert.
Automatisierte Datenbereinigungsskripte (Data Sanitization) scannen den Text und maskieren bekannte PII-Muster (Personally Identifiable Information) wie Namen, Adressen oder Telefonnummern.
Das Konzept der kontextuellen Anonymität scheitert jedoch kläglich an der Komplexität langer, emotional tiefgehender menschlicher Dialoge.
Sie könnten in einem Chat versehentlich extrem spezifische Details über Ihre seltene Krankheit, komplexe Familiendynamiken oder ein einzigartiges lokales Ereignis preisgeben.
Wenn diese kontextuellen Fragmente die Filter passieren und in die Gewichtungen eines neuronalen Netzes eingehen, können sie später unkontrolliert als Halluzination reproduziert werden.
Sich auf fehleranfällige Algorithmen zur Maskierung der eigenen Identität zu verlassen, gleicht einem digitalen Roulettespiel mit der eigenen Privatsphäre.
Strategische Datenminimierung: So schützen Sie Ihre digitale Identität
Wenn die Nutzung cloudbasierter KI-Begleiter unverzichtbar ist, stellt das Prinzip der strikten Datenminimierung (Data Minimization) die einzige effektive Verteidigungslinie dar.
Geben Sie der KI niemals reale identifizierende Merkmale: Verwenden Sie Pseudonyme, verfälschen Sie Ihren Wohnort und erwähnen Sie niemals konkrete Arbeitgeber.
Isolieren Sie die Anwendung von Ihrer Hauptidentität, indem Sie bei der Registrierung temporäre E-Mail-Aliase und virtuelle Einweg-Kreditkarten für Upgrades verwenden.
Gewöhnen Sie sich an, das Vektor-Gedächtnis Ihres KI-Begleiters regelmäßig manuell zu löschen, um die Akkumulation eines zu detaillierten Verhaltensprofils zu verhindern.
Vom Standpunkt der OpSec (Operations Security) müssen Sie jede Eingabe in ein Cloud-LLM so behandeln, als würden Sie sie auf einem öffentlichen schwarzen Brett posten.
Indem Sie die Qualität und Spezifität der von Ihnen produzierten Rohdaten kontrollieren, neutralisieren Sie die Bedrohung völlig unabhängig von der Backend-Sicherheit des Betreibers.
Häufig gestellte Fragen (FAQ)
Können Administratoren meine Chats mit der KI mitlesen?
Im regulären Betrieb liest niemand Ihre Chats manuell. Wenn das automatisierte System jedoch einen potenziellen Verstoß gegen die Nutzungsbedingungen oder illegale Inhalte erkennt, wird der entsprechende Chatabschnitt zur Überprüfung an ein menschliches Moderatorenteam weitergeleitet.
Warum gibt es keine Ende-zu-Ende-Verschlüsselung (E2EE) bei Cloud-KIs?
Ende-zu-Ende-Verschlüsselung bedeutet, dass nur Sender und Empfänger den Schlüssel besitzen. Da bei Cloud-KIs der Server den Text entschlüsseln muss, um ihn durch das neuronale Netz zu leiten und eine Antwort zu berechnen, ist E2EE technisch schlichtweg unmöglich.
Ist mein KI-Begleiter DSGVO-konform?
Dies variiert stark. Europäische oder US-Unternehmen, die offiziell auf dem EU-Markt agieren, müssen Mechanismen für Opt-outs beim Datentraining und Löschfristen anbieten. Viele Nischen-Apps aus dem asiatischen Raum ignorieren die DSGVO jedoch völlig und bieten kaum Datenschutz.
Wie kann ich absolute Privatsphäre garantieren?
Die einzige zu 100 % sichere Methode ist die Ausführung eines sogenannten Local LLM (z. B. via Ollama oder LM Studio) auf Ihrem eigenen PC. Dabei werden alle Berechnungen offline durchgeführt, und kein einziges Byte wird über das Internet an externe Server gesendet.
Sind meine Daten wirklich gelöscht, wenn ich den Account deaktiviere?
Meistens nicht sofort. Unternehmen behalten Kontodaten und Backups (Soft-Delete) oft für 30 bis 90 Tage auf ihren Servern. Um eine sofortige und dauerhafte Löschung zu erzwingen, müssen Sie oft explizit Ihr Recht auf Vergessenwerden nach Artikel 17 DSGVO beim Datenschutzbeauftragten einfordern.
Bereit für deine KI-Begleitung?
Erstelle einen persönlichen KI-Begleiter für dich. Entdecke mit unserem KI-Quiz aus nur 3 Fragen die beste Plattform, um deine KI-Freundin oder deinen KI-Freund zu erstellen, und zweifle nie wieder daran, welche die beste ist.
Meinen KI-Partner erstellen →