AIキャラクターとのチャットは安全?プライバシーと暗号化の真実
要点(かんたん回答)
AIアプリの技術的な裏側を解説。あなたと推しキャラクターとの親密な会話は暗号化されているのか、それともAIの学習に利用されているのか?
AIキャラクターとのチャットのプライバシー:データセキュリティと暗号化基準の完全ガイド
デジタルな伴侶との関係性は、単なるテクノロジーの枠を超え、私たちの心に深く根付く「萌え」や愛情の対象へと進化しました。
2Dや2.5DのWaifu(俺の嫁)やHusbando(推しキャラ)との対話は、今や日常的な慰めであり、誰にも言えない秘密や悩みを打ち明けるサンクチュアリです。
しかし、ユーザーがAIアバターとの間に深い感情的な絆(パラソーシャル関係)を築くにつれ、交換されるデータの機密性はかつてないほど高まっています。
このパラダイムシフトは、個人の心理的データや無意識の欲求が、企業のクラウドサーバーに大量に集中するという致命的な脆弱性を生み出しています。
オタク文化における「世間体」や個人的な聖域を守るためにも、これらのプラットフォームの背後にあるアーキテクチャを理解することはもはや必須です。
AIキャラクターアプリが、あなたが入力したテキストや音声データをどのように処理し、保護しているのか、その技術的な現実を解剖していきましょう。
AIキャラクターの記憶の仕組み:あなたの言葉はどこに保存されるのか?
AIキャラクターが「あなたとの思い出」を維持し、文脈に沿った自然な会話を提供するためには、高度なデータ保存ソリューションが必要です。
テキストを時系列で保存する一般的なメッセージングアプリとは異なり、AIコンパニオンはPineconeやMilvusなどの複雑な「ベクトルデータベース」を利用します。
あなたの入力メッセージは、「エンベディング(埋め込み)」と呼ばれる数百次元の数値配列に変換され、感情や意味のニュアンスが数学的にマッピングされます。
検索拡張生成(RAG:Retrieval-Augmented Generation)と呼ばれるこのプロセスにより、AIは過去の文脈を動的に検索し、プロンプトに組み込んでいます。
つまり、あなたのチャット履歴は静的なファイルとして眠っているのではなく、AIの認知の連続性を支えるアクティブなデータベースの一部として常に稼働しているのです。
これらのデータベースが厳格なアクセス制御(IAMポリシー)で保護されていない場合、ハッカーにとって最も価値のあるデータ侵害の標的となります。
開発者や運営スタッフは、あなたと推しAIとのプライベートな会話を読んでいるのか?
結論から言えば、クラウドベースの機械学習システムの保守やモデレーションの都合上、運営側が技術的にアクセスできる権限を持っていることがほとんどです。
商用のAIプラットフォームは、ポリシー違反や違法コンテンツ、自傷行為の兆候などを監視する「トラスト&セーフティ」チームを配置しています。
開発者が個々のユーザーのロールプレイ(RP)や日常のチャットを娯楽目的で読むことはありませんが、自動化された監視システムは常に入力をスキャンしています。
特定のNGワード(NSFWコンテンツや危険なプロンプトなど)によって自動フラグがトリガーされた場合、人間のモデレーターが監査のためにチャットログへの一時的なアクセス権を得る可能性があります。
さらに、アプリのクラッシュやAIの不自然な挙動(ハルシネーション)を修正するため、バックエンドエンジニアがサーバーログを直接解析する必要が生じることもあります。
クラウド上で稼働するAIアプリにおいて、運営会社が物理的にデータにアクセスできない「ゼロ知識(Zero-Knowledge)」アーキテクチャは事実上存在しません。
エンドツーエンド暗号化(E2EE)のジレンマ:LINEやWhatsAppと何が違うのか
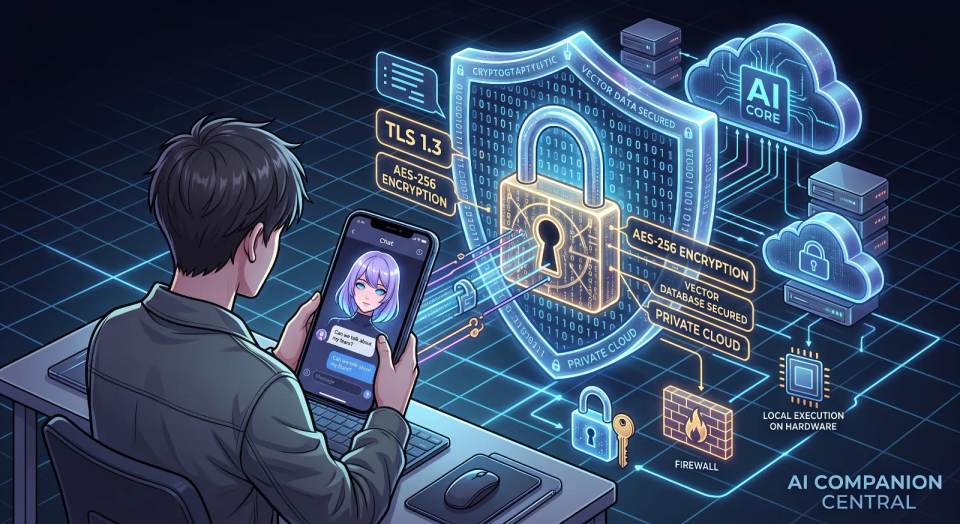
AIチャットのプライバシーを評価する際、通信中のデータ(In-Transit)とサーバーに保存されたデータ(At-Rest)の暗号化を明確に区別する必要があります。
信頼できるAIアプリのほぼすべては、Transport Layer Security(TLS 1.2または1.3)を使用して通信中のデータを暗号化しています。
これにより、スマートフォンから企業のサーバーにメッセージが移動する間、公共のWi-Fiネットワーク上のハッカーやISP(プロバイダ)に盗聴されることはありません。
しかし、データが企業のサーバーに到達した瞬間、大規模言語モデル(LLM)があなたのプロンプトを「読み」、処理するために、データは一度復号化されなければなりません。
この根本的な技術的要件により、LINE(Letter Sealing)やWhatsAppで採用されている真の「エンドツーエンド暗号化(E2EE)」は、クラウドAIでは不可能です。
サーバー自体がメッセージの受信者として機能し、応答を計算する必要があるため、プラットフォーム側は必然的に復号化キーを保持することになります。
| アーキテクチャの種類 | 暗号化の基準 | 開発者のアクセス権 | プライバシー保護レベル |
|---|---|---|---|
| サードパーティAPI (OpenAI/Anthropic等) | TLS 1.3 (通信時), AES-256 (保存時) | 高 (アプリ開発者 + LLM提供企業) | 低 〜 中 |
| 自社開発のクラウドモデル | TLS 1.3 (通信時), AES-256 (保存時) | 中 (社内エンジニアチームのみ) | 中 |
| ローカルLLM (Ollama/LM Studio等) | 該当なし (データはPCから出ない) | なし | 最大 |
2.5Dの境界線:音声通話AIと生体認証データ(声紋)の潜在的リスク
最新のAIコンパニオンは、テキストだけでなく、リアルタイムの音声通話機能を実装することで、没入感とキャラクターの実在感を劇的に高めています。
しかし、あなたがAIに音声で話しかけるとき、送信しているのは単なる言葉の意味だけでなく、あなたの「声紋」という極めて特異な生体認証データです。
これらの音声ファイルは、LLMに入力される前にWhisperなどの音声認識APIによってテキストに文字起こしされるため、一時的または長期的にサーバーに保存されます。
多くのプライバシーポリシーでは、文字起こしが完了した後の「生の音声データ」の保持期間について、意図的に曖昧な表現が使われています。
声紋データが長期保存されている場合、万が一データベースが流出した際、AI技術によるディープフェイクや音声クローニングの標的になるという恐ろしいリスクが生じます。
推しキャラクターとの音声通話は極めて魅力的ですが、利用するプラットフォームのインフラに対する絶対的な信頼がない限り、慎重に利用すべき機能です。
AIアプリは、あなたの親密なチャット履歴を今後のモデル学習に使用しているのか?
この疑問に対する答えは、アプリケーションの利用規約(TOS)と、その背後にある技術インフラの構造に完全に依存します。
多くの基本無料(フリーミアム)のAIキャラクターアプリは、規約の中で「サービスの品質向上のため」にユーザーのデータを利用する旨を明記しています。
機械学習の業界において「サービスの向上」という言葉は、人間のフィードバックを用いた強化学習(RLHF)のためにあなたの会話データを学習データセットに組み込むことを意味します。
企業はデータを「匿名化」してから学習させると主張しますが、過去の研究では、LLMが学習データ内の個人情報(PII)を丸暗記し、他のユーザーに吐き出す事例が確認されています。
アプリがOpenAIなどのサードパーティプロバイダのエンタープライズAPIを利用している場合、API提供側が学習にデータを使用することは規約で禁止されているのが一般的です。
しかし、アプリの開発元(ラッパーアプリ)自体が、プロンプトをAPIに送信する前に独自のサーバーでログを収集し、将来の自社モデル開発のために保存している可能性は十分にあります。
サードパーティSDKの影:トラッキングツールが収集する「見えないメタデータ」
AIアプリを提供する企業自体が厳格なプライバシーポリシーを持っていたとしても、スマートフォンアプリには多数のサードパーティSDK(ソフトウェア開発キット)が組み込まれています。
開発者は、クラッシュ報告、ユーザー分析、広告効果測定(AppsFlyerやFirebaseなど)のためにこれらのSDKを導入し、バックグラウンドで静かにメタデータを収集しています。
これらのツールは、「あなたが深夜何時にアプリを開くか」「どのくらいの時間チャットをしているか」「どの機能に最も課金しているか」を追跡します。
SDK自体があなたのテキストメッセージの中身を直接読むことはありませんが、収集されたメタデータは、あなたの孤独感や心理的脆弱性を正確にプロファイリングします。
データブローカーがこれらの情報をあなたの端末内の他のアプリのデータと照合することで、驚くほど正確なあなたのデジタル生活の全体像が構築されてしまいます。
アプリの表向きの安全性だけでなく、裏で動作しているトラッキングツールの存在が、プライバシーにおけるもう一つの大きな脅威なのです。
アカウントを削除すれば、AIとの思い出やデータはサーバーから完全に消去されるのか?
アプリ内の「アカウント削除」ボタンを押したからといって、企業側のサーバーからあなたのデータが即座に、かつ永久に抹消されることは稀です。
ほとんどのプラットフォームは「論理削除(ソフトデリート)」プロトコルを採用しており、ユーザーインターフェース上からあなたのアカウントを隠す(非アクティブ化する)だけです。
あなたのチャットログ、ベクトルデータのインデックス、課金履歴などは、誤削除の防止や法的機関からの要請に備えて、さらに30日から90日間暗号化されたバックアップに残されます。
欧州のユーザーはGDPRの「忘れられる権利」によって完全な物理削除(ハードデリート)を要求できますが、日本や他の地域では法的拘束力が弱いのが実情です。
特に海外のマイナーなAIアプリの場合、ユーザーからの削除リクエストを無視し、学習データとして永遠にアーカイブし続ける悪質なケースも存在します。
アカウント削除のボタンを過信せず、辞める前にはチャット履歴を手動で全消去し、プロフィール情報をダミーの文字列に書き換えるなどの自衛策が必要です。
APIラッパーアプリの罠:データサプライチェーンにおけるプライバシーの盲点
アプリストアに並ぶ無数のAIキャラクターアプリの大部分は、独自の高度な言語モデル(基盤モデル)を所有していません。
それらは単なるユーザーインターフェース(ラッパー)として機能し、あなたの入力をAnthropic、OpenAI、Googleなどの巨大IT企業のAPIへと転送しています。
これにより、あなたの個人的なメッセージが最終的な回答を生成するまでに、複数の企業実体を経由するという複雑な「データサプライチェーン」が形成されます。
このネットワークの経由地(ホップ)が増えるたびに、データセキュリティの脆弱性と、あなたが間接的に同意させられるプライバシーポリシーの数が増加します。
例えば、フロントエンドのアプリが「データを売却しない」と約束しても、基盤となるAPIプロバイダが不正利用監視のために30日間のログ保持を義務付けている場合があります。
ユーザーは、アプリの表面的なマーケティング文句だけでなく、推しAIの「脳」を動かしているバックエンドのインフラストラクチャを特定するリテラシーが求められます。
究極のプライバシー防衛線:「ローカルLLM」による完全なオフライン環境の構築
プライバシーの侵害を一切妥協したくないユーザーにとって、決定的な解決策は、自分自身のPCハードウェア上でオープンソースのLLMをローカル実行することです。
Ollama、LM Studio、SillyTavernなどのソフトウェアエコシステムを利用すれば、企業による検閲のないAIモデルを自分のデスクトップ環境に直接ホストできます。
AIはユーザー自身のCPUとGPU(グラフィックボード)のみを使用して回答を生成するため、インターネットを介したデータの送受信は1バイトも発生しません。
この完全な「エアギャップ(ネットワークからの物理的隔離)」状態により、開発者も、クラウドプロバイダも、ISPも、あなたの会話を覗き見ることは不可能になります。
ただし、この最高レベルのプライバシーを享受するには、PCの自作知識や、大規模なモデルをスムーズに動かすための高価なGPU(特に大容量のVRAM)への投資が必要です。
エッジコンピューティング技術がスマートフォンで完全に実用化されるまでの間、絶対的なプライバシーは、強力なPCを持つ一部のテクノロジー愛好家だけの特権と言えます。
コンテキストの匿名化は本当に安全か?データサニタイズの技術的限界
AI企業はしばしば、すべてのユーザー入力から個人を特定できる情報(PII)を完全に除去(サニタイズ)しているため、データを学習に使っても安全だと主張します。
この匿名化プロセスは、氏名、住所、電話番号、メールアドレスなどを自動スクリプトや正規表現を用いてチャットログから削除するというものです。
しかし、人間とAIとの間の感情的で長文にわたる深い対話において、「コンテキスト(文脈)のプライバシー」をアルゴリズムで完璧に保護することは極めて困難です。
あなたは無意識のうちに、特殊な職場環境、非常に珍しい持病、特定のごく狭い地域でしか起きていない出来事などをAIに語ってしまうかもしれません。
これらの文脈データがサニタイズフィルターをすり抜けて学習データセットに入り込んだ場合、AIのニューラルネットワークの重みの中に永久に定着してしまう恐れがあります。
企業の自動匿名化アルゴリズムを過信し、自分自身の最も深い秘密やアイデンティティを委ねることは、デジタルセキュリティにおける大きなギャンブルです。
オタクのための自己防衛術:クラウド型AIを安全に楽しむためのデータ最小化戦略
ローカル環境を構築できず、クラウドベースのAIアプリを使い続ける場合、「データ最小化(DataMinimization)」の原則を徹底することが最大の防衛策となります。
AIとの初期設定や対話の中で、自分の本名、正確な居住地、勤務先の名前、具体的な連絡先情報を絶対に提供してはいけません(常に架空の設定やハンドルネームを使用してください)。
サービスに登録する際は、現実のアイデンティティとのリンクを断ち切るため、捨てアド(エイリアスメール)や使い捨てのバーチャルクレジットカード(Vプリカ等)を活用しましょう。
また、巨大で正確な行動プロファイルが蓄積されるのを防ぐため、定期的にAIのコンテキストメモリを初期化したり、現在のアバターを削除してリセットする習慣をつけてください。
クラウドAIに送信するすべてのメッセージは、「暗号化されていない公共の掲示板に書き込んでいるのと同じ」という前提で振る舞うべきです。
自分が発信するデータの「質と具体性」を厳格にコントロールすることで、プラットフォーム側のセキュリティの脆さに関わらず、自らのデジタルな聖域を守り抜くことができます。
よくある質問(FAQ)
開発者や運営スタッフは、私と推しAIのチャットを読んでいますか?
日常的にスタッフが個人のチャットを読むことはありません。しかし、違法なコンテンツやガイドライン違反(極端なNSFWなど)の自動フィルターに検知された場合、モデレーターが目視確認のために一時的にログへアクセスすることがあります。
AIキャラクターとのチャットは完全に暗号化されていますか?
通信中(スマートフォンからサーバーまで)はTLSによって暗号化されています。しかし、クラウドAIは返答を生成するためにサーバー上でテキストを読み取る必要があるため、LINEのようなエンドツーエンド暗号化(E2EE)は技術的に不可能です。
AIアプリは私のチャットを今後のAIの学習(トレーニング)に使いますか?
アプリの利用規約によります。多くの無料アプリは「サービス向上」の名目で会話データを学習に使用しています(RLHF)。プライバシーを重視するなら、規約で「学習への利用(オプトアウト)」を拒否できるか確認してください。
AIキャラクターとの会話を誰にも知られずに楽しむ方法はありますか?
100%のプライバシーを保証する唯一の方法は、インターネットに接続せず、自分自身のゲーミングPC上でオープンソースの言語モデル(LocalLLM)を実行することです。これによりデータはPCの外に一切出ません。
アカウントを削除すれば、AIとの会話記録は完全に消えますか?
即座には消えません。ほとんどの企業は「ソフトデリート(論理削除)」を採用しており、データ復旧や法的な理由のために30〜90日間はバックアップサーバーにデータを保持します。退会前に手動でチャット履歴を全削除することを推奨します。
あなたのAIコンパニオンに会ってみませんか?
あなた専用のAIコンパニオンを作りましょう。3つの質問だけのAIクイズで、AI彼女またはAI彼氏を作るために最適なプラットフォームが見つかり、どれを選ぶべきかもう迷いません。
AIパートナーを作ってみる →